
Crawl budget - czym jest i jak go optymalizować
Crawl budget to zbiór adresów URL, które Google może i chce przeskanować w danej witrynie. Większość stron nie musi się nim przejmować, i to nie jest nasza opinia, tylko zdanie z dokumentacji Google. Temat robi się poważny w sklepach internetowych, portalach i serwisach ogłoszeniowych, które mają dziesiątki tysięcy podstron i zmieniają je codziennie. Niżej wyjaśniamy, jak działa budżet, jak sprawdzić, czy wasza strona ma z nim problem, i które popularne porady są sprzeczne z aktualnymi wytycznymi. Stan wiedzy: 1 października 2026, na podstawie poradnika Google zaktualizowanego 22 lipca 2026.
Czym jest crawl budget
Robot wyszukiwarki nie pobiera wszystkich stron witryny naraz i bez końca. Ma ograniczone zasoby, a wydajność serwera, na którym stoi wasza strona, też ma granice. Crawl budget określa, ile adresów URL robot Google przeskanuje w określonym czasie i które wybierze. W dokumentacji Google to „the set of URLs that Google can and wants to crawl”, czyli zbiór adresów, które Google może i chce pobrać.
W polskiej wersji dokumentacji pojęcie nazywa się „budżet indeksowania”. Tłumaczenie Google używa słowa „indeksowanie” na określenie crawlingu, czyli skanowania, i w kilku miejscach miesza oba słowa. W tym tekście piszemy „skanowanie”, a nazwy raportów z Search Console podajemy dosłownie, tak jak zobaczycie je w interfejsie.
Ważny szczegół, którego nie podaje prawie żaden poradnik: budżet liczy się osobno dla każdej nazwy hosta. www.example.com i sklep.example.com mają dwa oddzielne budżety. Jeśli blog stoi na subdomenie, nie zabiera budżetu sklepowi.
Crawl budget a indeksowanie - dlaczego to nie to samo
Skanowanie to pobranie strony przez robota. Indeksowanie to decyzja, czy pobrana strona trafi do indeksu Google. Ranking to kolejność w wynikach wyszukiwania. Crawl budget dotyczy tylko pierwszego kroku.
Strona, której robot nie pobrał, nie trafi do indeksu. Strona pobrana nie musi jednak do niego trafić, a strona zaindeksowana nie dostaje dzięki temu lepszej pozycji. Google pisze wprost na stronie o mitach na temat skanowania, że skanowanie „it's not a ranking signal”. Częstsze wizyty robota nie podnoszą pozycji. Budżet wpływa na widoczność witryny tylko pośrednio: nowe i zmienione strony trafiają do wyników z opóźnieniem albo wcale.
Jeśli wasz problem to strona, która w ogóle nie pojawia się w Google, zacznijcie od poradnika jak zaindeksować stronę w Google. Crawl budget to zwykle dopiero kolejny etap diagnozy.
Z czego składa się budżet: crawl rate limit i crawl demand
Google opisuje wielkość crawl budgetu jako wypadkową dwóch elementów. Pierwszy mówi, ile robot może pobrać bez przeciążania serwera. Drugi mówi, ile chce pobrać.
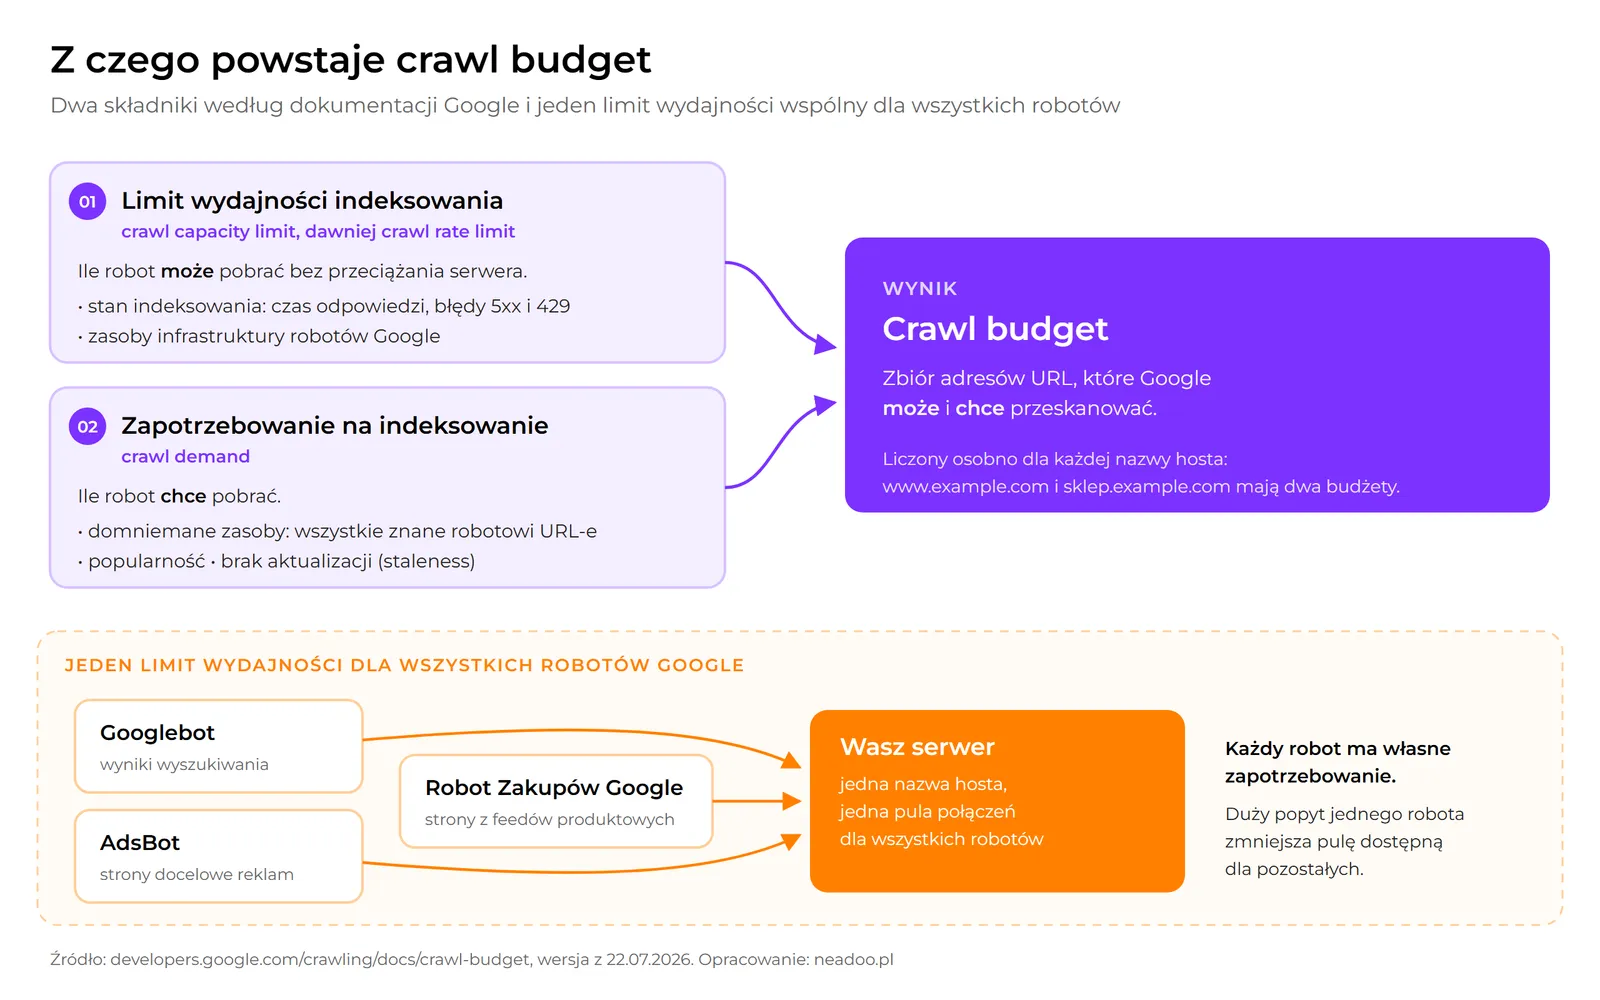
Rys. 1. Z czego powstaje crawl budget. Źródło: dokumentacja Google, wersja z 22.07.2026. Opracowanie: neadoo.pl
Limit wydajności indeksowania (crawl capacity limit, dawniej crawl rate limit)
W polskiej dokumentacji ten element nazywa się „limit wydajności indeksowania”, w angielskiej „crawl capacity limit”, a wewnętrznie także hostload. Większość artykułów w polskim internecie używa starszej nazwy „crawl rate limit”, wprowadzonej w poście Gary'ego Illyesa ze stycznia 2017. Chodzi o to samo zjawisko.
Limit określa, ile połączeń równoległych robot otwiera z serwerem i jak długo je trzyma. Według dokumentacji każda witryna zaczyna od tego samego, ostrożnego limitu. Google podnosi go, gdy serwer odpowiada szybko, a jest na co go wydać. Obniża, gdy serwer działa wolno albo zwraca błędy 5xx i kod 429. Ten czynnik Google nazywa crawl health, po polsku „stan indeksowania”. Błędy serwera obniżają więc dostępny crawl budget szybciej niż cokolwiek innego. Robot celowo nie ma przeciążać serwera. Szybkość odpowiedzi jest więc pierwszą rzeczą, która ogranicza budżet w dużym serwisie.
Drugi czynnik leży po stronie Google: zasoby samej infrastruktury robotów są skończone i Google rozdziela je między wszystkie witryny.
Zapotrzebowanie na indeksowanie (crawl demand)
Crawl demand mówi, ile Google chce skanować. Dla Googlebota zależy to od rozmiaru witryny, częstotliwości aktualizacji, jakości treści i jej trafności na tle innych serwisów. Dokumentacja wymienia trzy czynniki:
- Domniemane zasoby (perceived inventory). Wszystkie adresy URL, o których robot wie, łącznie z duplikatami i adresami, których nie chcecie w Google. Google pisze, że to czynnik, nad którym macie największą kontrolę.
- Popularność. Strony wysokiej popularności robot odwiedza częściej.
- Brak aktualizacji (staleness). Google chce mieć w indeksie aktualną wersję strony, więc wraca do treści, które się zmieniają.
Zapotrzebowanie rośnie też skokowo po przeniesieniu serwisu na nowe adresy, bo robot musi przeskanować wszystko od nowa.
Jeden limit dla wszystkich robotów Google
To zmiana, której nie uwzględnia żaden polski poradnik z czołówki wyników wyszukiwania. Aktualna wersja dokumentacji mówi, że limit wydajności jest wspólny dla wszystkich robotów Google. Każdy robot ma własne zapotrzebowanie. AdsBot skanuje strony docelowe reklam dynamicznych, robot Zakupów Google pobiera strony z feedów produktowych. Wszystkie korzystają jednak z tej samej puli połączeń z waszym serwerem. Duże zapotrzebowanie jednego robota zmniejsza pulę dostępną dla pozostałych.
W grudniu 2025 Google przeniósł poradnik z Search Central do osobnego serwisu o skanowaniu. W dzienniku zmian podaje powód: ta sama infrastruktura obsługuje również Zakupy, Wiadomości, Gemini i AdSense. Dla sklepu z kampaniami produktowymi oznacza to, że ruch robotów reklamowych i wyszukiwarkowych dzieli jeden limit.
Czy crawl budget dotyczy waszej strony?
Zanim zaczniecie optymalizację crawl budgetu, sprawdźcie, czy macie co optymalizować. Według dokumentacji Google poradnik jest przeznaczony dla:
- dużych witryn, ponad milion unikalnych stron, z treścią zmieniającą się umiarkowanie często, mniej więcej raz w tygodniu;
- średnich lub większych witryn, ponad 10 tys. unikalnych stron, z treścią zmieniającą się bardzo szybko, codziennie;
- witryn, w których duża część adresów URL ma w Search Console status „Strona wykryta - obecnie niezindeksowana”.
Google zastrzega, że to „nie są sztywne progi”, tylko orientacyjne wartości. Podaje też prostszy test: jeśli nowe strony są skanowane w dniu publikacji, poradnik nie jest wam potrzebny. Wystarczy aktualna mapa witryny i regularne zaglądanie do raportu „Indeksowanie stron”.
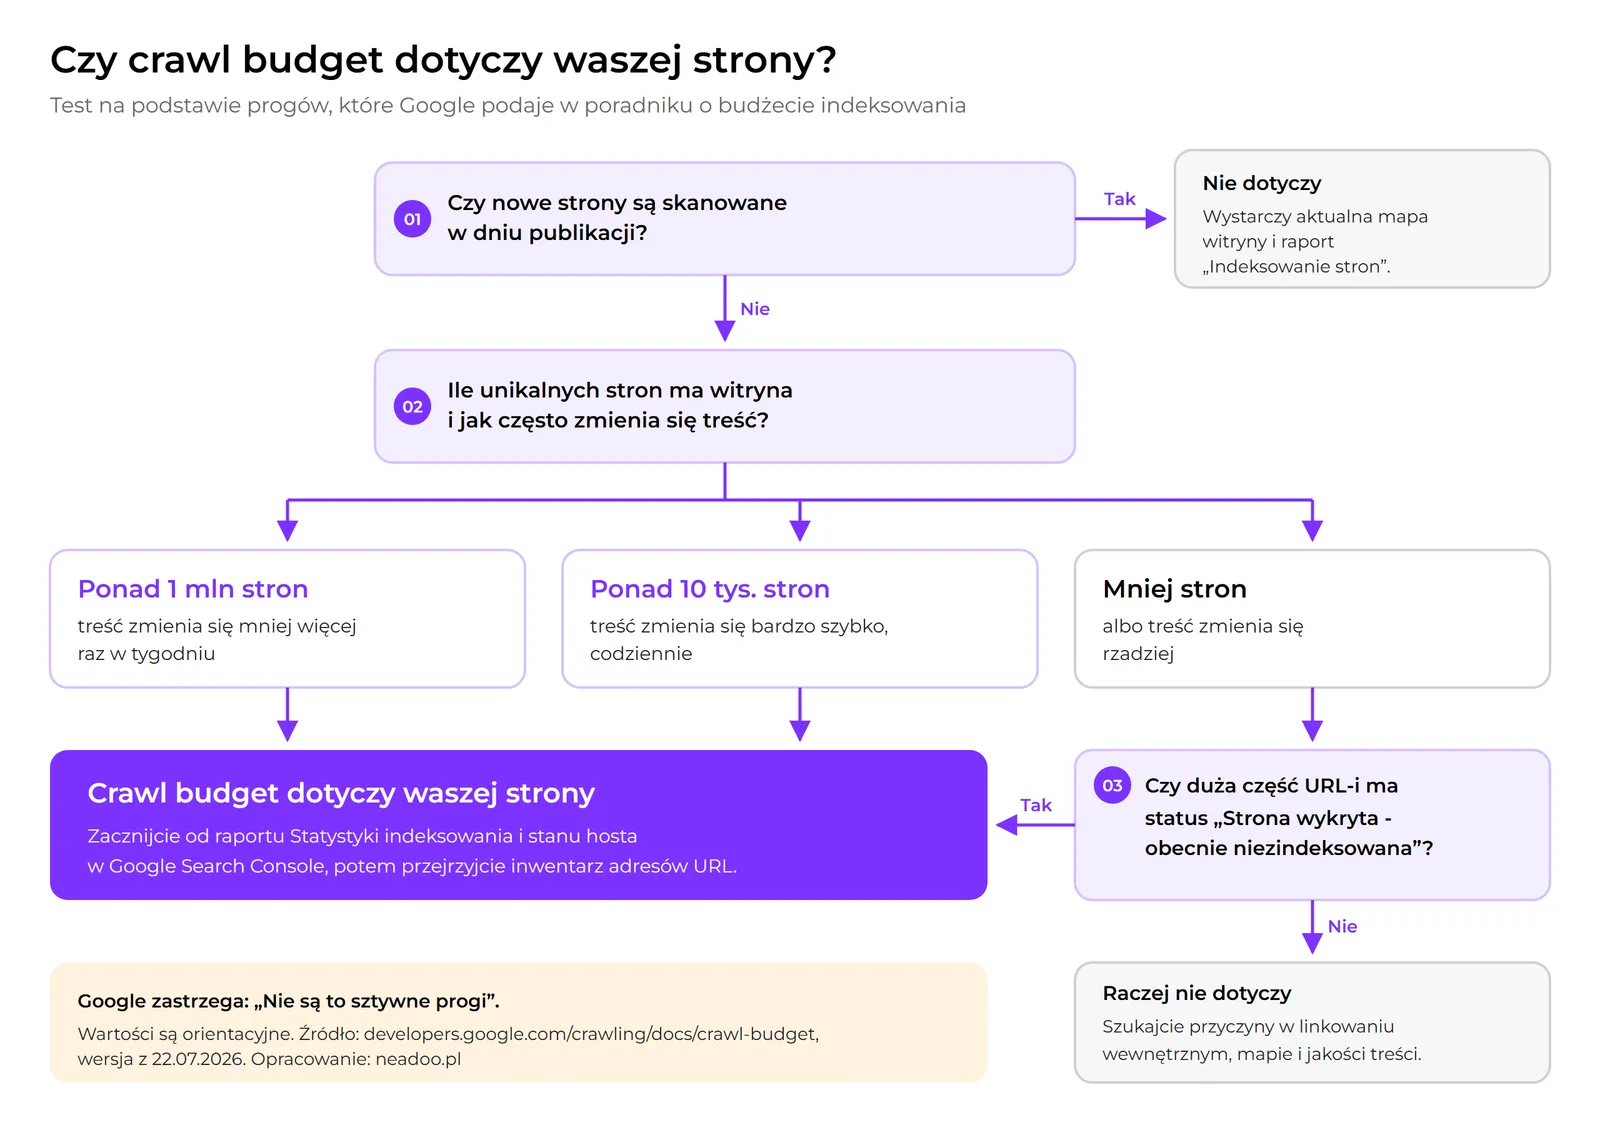
Rys. 2. Czy crawl budget dotyczy waszej strony. Google zastrzega, że to nie są sztywne progi. Opracowanie: neadoo.pl
W praktyce sprawdzamy to w trzech krokach:
- Ile adresów URL faktycznie generuje witryna, łącznie z filtrami, sortowaniem i parametrami. Sklep z 5 tys. produktów może mieć setki tysięcy kombinacji filtrów, a robot liczy każdą z nich.
- Jak szybko robot odwiedza nowe strony. Opublikujcie stronę i po dniu sprawdźcie ją w Narzędziu do sprawdzania adresu URL.
- Ile stron ma status „Strona wykryta - obecnie niezindeksowana” i czy ta liczba rośnie.
Jeśli serwis ma kilkaset podstron, a nowe wpisy pojawiają się w Google po dniu lub dwóch, crawl budget nie jest waszym problemem. Wolne indeksowanie małej strony ma zwykle inną przyczynę: słabe linkowanie wewnętrzne, brak mapy strony albo treść, którą Google uznaje za mało wartościową. To kwestie, od których zaczyna się każde pozycjonowanie strony, zanim w ogóle pojawi się pytanie o budżet.
Sprawdźmy potencjał Twojej strony
Podaj adres swojej strony i e-mail - odezwiemy się z konkretną analizą, bez zobowiązań.
Jak sprawdzić crawl budget w Google Search Console
Google nie podaje jednej liczby, która byłaby „waszym budżetem”. Stan crawl budgetu trzeba odczytać z kilku źródeł naraz, a podstawowym jest Google Search Console.
Raport Statystyki indeksowania
Znajdziecie go w Google Search Console w sekcji Ustawienia > Statystyki indeksowania. Raport pokazuje łączną liczbę żądań robota, łączny rozmiar pobranych danych i średni czas odpowiedzi serwera w czasie. Niżej są podziały żądań według kodu odpowiedzi, typu pliku, celu skanowania (wykrycie nowej strony albo odświeżenie znanej) i typu Googlebota.
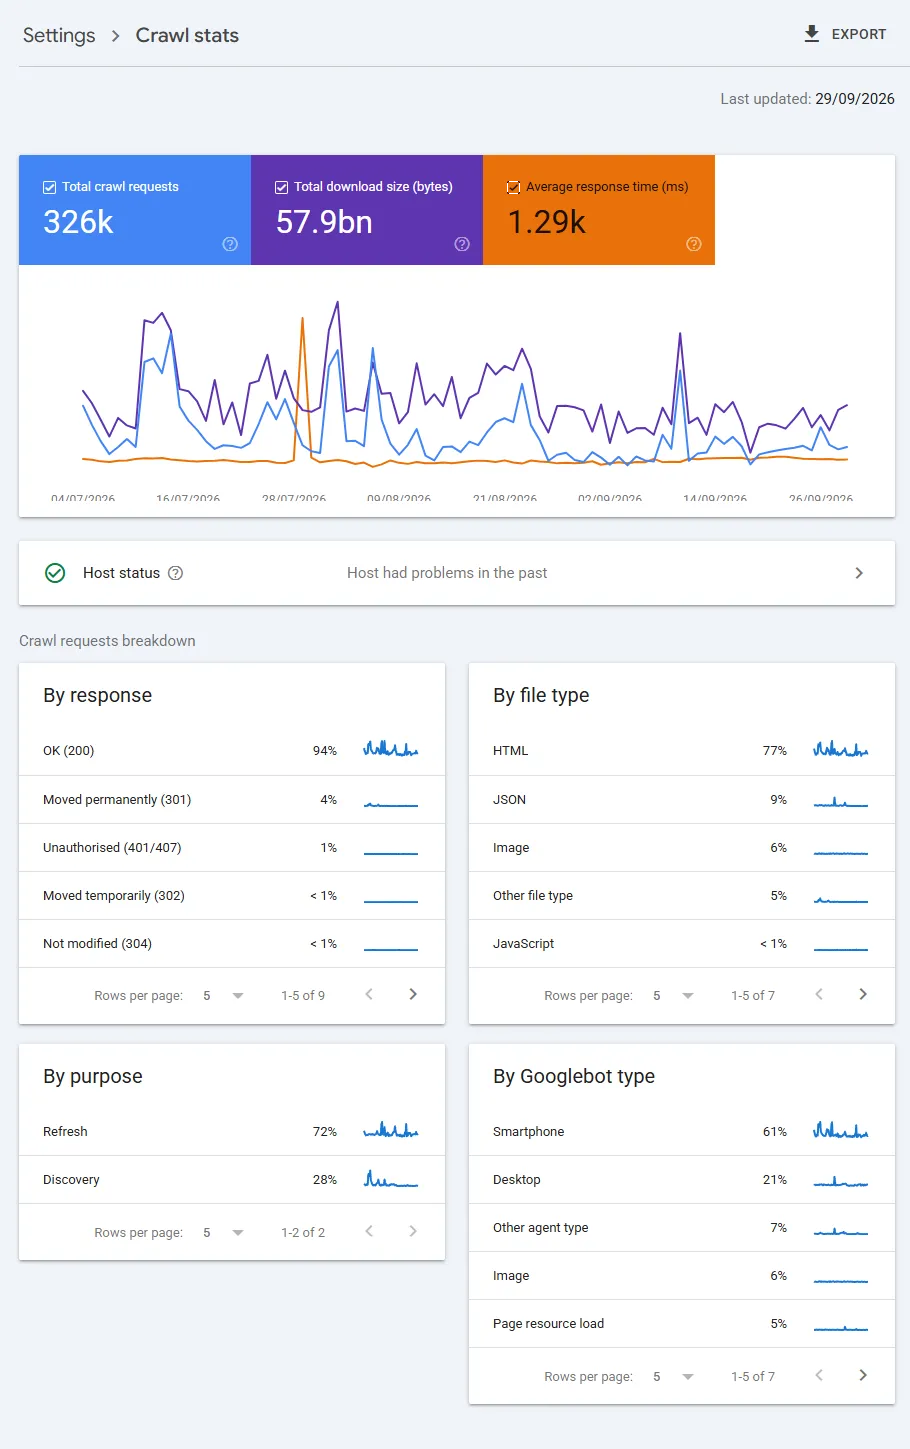
Rys. 3. Raport Statystyki indeksowania dużego sklepu internetowego, ostatnie 90 dni. Zrzut z Google Search Console z 2 października 2026, dane zanonimizowane.
Najważniejsza część to stan hosta. Google zaleca ją w poradniku o problemach ze skanowaniem. Wykres dostępności hosta ma czerwoną linię limitu. Jeśli liczba żądań dobija do tej linii, serwer ogranicza skanowanie. Google proponuje wtedy prosty test: zwiększyć zasoby serwera na miesiąc i sprawdzić, czy liczba żądań wzrosła.
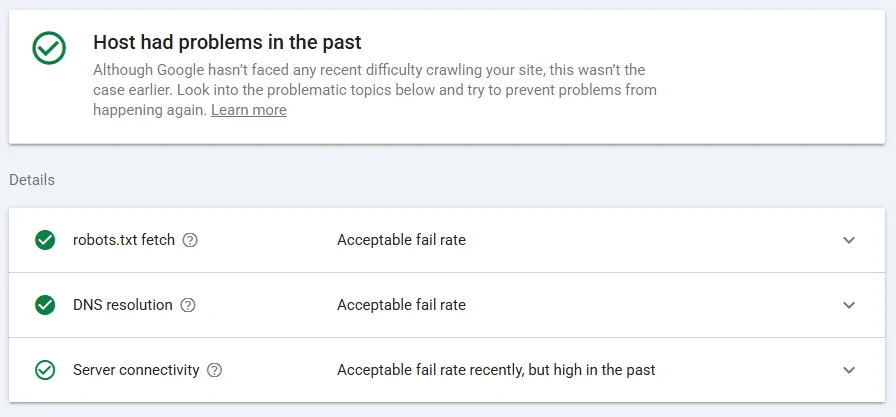
Rys. 4. Stan hosta w tym samym sklepie. Google nie ma dziś problemów ze skanowaniem, ale wcześniej łączność z serwerem zawodziła zbyt często. Zrzut z Google Search Console z 2 października 2026.
Na co patrzeć przy regularnym monitorowaniu:
- czy średni czas odpowiedzi rośnie, kiedy rośnie liczba żądań;
- jaki odsetek żądań kończy się kodami 5xx i przekierowaniami;
- ile żądań idzie na pliki JS i CSS w porównaniu z HTML;
- czy przeważa odświeżanie znanych stron, czy wykrywanie nowych.
Status „Strona wykryta - obecnie niezindeksowana”
Raport „Indeksowanie stron” w Google Search Console pokazuje adresy, które Google zna, ale jeszcze ich nie przeskanował. Kilka takich adresów nie jest problemem. Tysiące adresów, których liczba rośnie z tygodnia na tydzień, to jeden z sygnałów, które dokumentacja wprost wiąże z budżetem.
Komunikat „Przekroczono limit obciążenia hosta”
W Narzędziu do sprawdzania adresu URL może się pojawić komunikat „Przekroczono limit obciążenia hosta” (Hostload exceeded). Według Google oznacza on, że robot nie pobrał strony, bo serwer był na granicy swoich możliwości. To najbardziej bezpośredni dowód, że ogranicza was limit wydajności, a nie zapotrzebowanie.
Logi serwera
Search Console pokazuje dane zagregowane. Logi serwera pokazują każde żądanie robota z adresem URL i kodem odpowiedzi. Tylko z logów dowiecie się, czy robot spędza dzień na kombinacjach filtrów zamiast na kartach produktów. Zanim wyciągniecie wnioski, odfiltrujcie ruch podszywający się pod Googlebota. Google opisuje w dokumentacji robotów weryfikację przez odwrotne zapytanie DNS.
Co marnuje crawl budget
W poście z 2017 roku Google wymienił kategorie adresów niskiej wartości, które mogą negatywnie wpływać na skanowanie i indeksowanie. Kolejność według znaczenia, jak w oryginale:
- Nawigacja fasetowa i identyfikatory sesji w adresach URL.
- Duplikaty treści w obrębie witryny, czyli te same produkty i opisy pod wieloma adresami.
- Miękkie błędy (soft 404), czyli strony z komunikatem „brak produktu”, które zwracają kod 200.
- Zhakowane strony.
- Nieskończone przestrzenie i proxy, na przykład kalendarz z linkiem „następny miesiąc” bez końca.
- Treści niskiej jakości i spam.
Aktualna dokumentacja dodaje do tego warianty sortowania i nieskończone przewijanie, które generuje nowe adresy. Każdy z tych problemów ma ten sam mechanizm: zwiększa liczbę adresów URL, o których robot wie, bez zwiększania liczby wartościowych stron. Robot wybiera spośród nich, które przeskanować, i część crawl budgetu idzie na strony, których nie chcecie w wynikach wyszukiwania, zamiast na kluczowe podstrony.
Dwie pozycje często pomijane w poradnikach. Pierwsza to wersje alternatywne i zasoby. Strona o mitach potwierdza, że adresy AMP i hreflang, pliki CSS i JS oraz wywołania XHR zużywają budżet. Serwis w dziesięciu językach ma dziesięciokrotnie więcej adresów do pobrania. Druga to łańcuchy przekierowań. Każdy przeskok to osobne żądanie, a dokumentacja wprost zaleca unikanie długich łańcuchów.
Jak optymalizować crawl budget - zalecenia Google
Poniższa lista pochodzi z aktualnej dokumentacji. Przy każdym punkcie piszemy, co zrobić w praktyce.
- Zarządzajcie inwentarzem adresów URL. Ustalcie, które typy stron mają być w Google, a które nie. Tu macie największy wpływ na crawl budget strony, bo decydujecie, co robot w ogóle zobaczy.
- Konsolidujcie duplikaty. Jeśli ta sama treść jest pod kilkoma adresami, zostawcie jeden. Każda kopia zduplikowanych treści to kolejny adres w kolejce. Usuńcie zbędne warianty albo wskażcie wersję kanoniczną.
- Blokujcie w robots.txt adresy, których robot nie powinien pobierać. Dotyczy to wyników wyszukiwarki wewnętrznej, wariantów sortowania, koszyka, strony logowania i nieskończonego przewijania. Składnię i typowe reguły opisaliśmy w tekście o pliku robots.txt.
- Zwracajcie 404 albo 410 dla stron usuniętych na stałe. Google nazywa kod 404 silnym sygnałem, żeby nie skanować adresu ponownie.
- Usuwajcie miękkie błędy 404. Strona „produkt niedostępny” z kodem 200 jest dla robota normalną stroną i wraca do kolejki. Listę takich adresów znajdziecie w raporcie „Indeksowanie stron”.
- Aktualizujcie mapę witryny i używajcie
<lastmod>. Data ostatniej zmiany podpowiada robotowi, które strony odświeżyć. Musi być prawdziwa, nie generowana przy każdym wejściu. Więcej w tekście o mapie strony internetowej. - Unikajcie łańcuchów przekierowań. Linki wewnętrzne powinny prowadzić prosto do docelowego adresu, nie przez przekierowanie.
- Przyspieszcie ładowanie i renderowanie. Szybsza odpowiedź serwera to wyższy limit wydajności. Ważna jest też liczba zasobów potrzebnych do wyrenderowania strony, bo każdy z nich to osobne żądanie.
- Obsługujcie kod 304 Not Modified. Jeśli strona się nie zmieniła, serwer może odpowiedzieć krótko, bez przesyłania całej treści. Robot oszczędza czas, a serwer transfer. Ta pozycja nie pojawia się w żadnym z polskich poradników z pierwszej dziesiątki wyników.
Do tej listy dodajemy linkowanie wewnętrzne. Strona, do której prowadzi jeden link z dziesiątej strony paginacji, jest dla robota trudno osiągalna. Logiczna struktura witryny i linki z ważniejszych podstron kierują robota do kluczowych stron serwisu. Więcej o budowaniu tej struktury w tekście o linkowaniu wewnętrznym.
Czego nie robić, choć radzi tak połowa poradników
Ta sekcja jest najważniejsza w całym tekście. Sprawdziliśmy kilkanaście artykułów z pierwszej strony wyników na frazę crawl budget. Prawie każdy zawiera co najmniej jedną z poniższych porad, a dokumentacja Google mówi o każdej z nich co innego.
| Popularna porada | Co mówi dokumentacja Google | Źródło |
|---|---|---|
| Mit | ||
| | Noindex oszczędza crawl budget. | Robot musi pobrać stronę, żeby odczytać tag, więc czas skanowania i tak jest zużyty. Google pisze wprost: „Don't use noindex”. | Poradnik o budżecie | | Mit |
|
| | Blokada w robots.txt przesuwa budżet na ważniejsze strony. | Google zabrania tymczasowego przenoszenia budżetu przez robots.txt. Zwolniony budżet nie przechodzi na inne strony, chyba że serwis już dobija do limitu wydajności. | Poradnik o budżecie | | Mit |
|
| | Błędy 404 marnują crawl budget. | Strony 4xx, z wyjątkiem 429, nie marnują budżetu. Kod 404 to dla robota sygnał, żeby nie wracać do adresu. | Mity o skanowaniu | | Mit |
|
|
| Reguła crawl-delay w robots.txt spowolni Googlebota. | Google nie obsługuje reguły crawl-delay. | Mity o skanowaniu |
| Mit |
|
| | Szybkość skanowania ustawicie w Search Console. | Ustawienie wycofano 8 stycznia 2024. Zostaje formularz, ale służy tylko do zgłaszania zbyt intensywnego skanowania. | Blog Google, 11.2023 | | Mit |
|
| | Tagi rel="prev" i rel="next" pomagają robotowi przy paginacji. | Google nie używa tych tagów. Dla robota to zwykłe linki. | Paginacja | | Mit |
|
| | Nofollow zamyka stronę przed robotem. | Nofollow wpływa na budżet tylko częściowo. Adres znaleziony w innym linku robot i tak pobierze. | Mity o skanowaniu | | Mit |
|
| | Większy crawl budget poprawia pozycje. | Skanowanie jest konieczne, żeby strona trafiła do wyników, ale „it's not a ranking signal”. | Mity o skanowaniu |
Tab. 1. Popularne porady o crawl budgecie a dokumentacja Google. Stan na 2 października 2026.
Noindex nie oszczędza budżetu. Dokumentacja mówi wprost: „Don't use noindex”. Żeby zobaczyć tag noindex, robot musi pobrać stronę. Pobiera ją, odczytuje tag i dopiero wtedy odrzuca, a czas skanowania jest już zużyty. Noindex służy do wykluczenia strony z indeksu, nie do oszczędzania budżetu.
Robots.txt nie przesuwa budżetu na inne strony. Google zabrania używania robots.txt do tymczasowego przenoszenia budżetu. Zwolniony budżet nie przechodzi automatycznie na inne strony, chyba że serwis już dobija do limitu wydajności. Adresy zablokowane w robots.txt zostają w kolejce znacznie dłużej i robot wraca do nich po zdjęciu blokady.
Reguła crawl-delay nie działa w Google. Część poradników radzi ograniczyć skanowanie wpisem w robots.txt. Według strony o mitach Google nie obsługuje reguły crawl-delay.
Błędy 404 nie marnują budżetu. To najczęstszy mit w polskich artykułach. Strona o mitach mówi, że strony 4xx, z wyjątkiem 429, „don't waste crawl budget”. Przekierowywanie każdej usuniętej strony na stronę główną albo kategorię nie oszczędza budżetu. Wręcz przeciwnie, tworzy przekierowania, które robot musi obsłużyć.
Nie ma już ustawienia szybkości indeksowania w Search Console. Narzędzie do ograniczania szybkości skanowania Google wycofał 8 stycznia 2024. Zwiększenia szybkości nie dało się ustawić nigdy, tylko jej zmniejszenie. Poradnik, który każe „ustawić wyższe limity w panelu”, opisuje rzecz, której nie ma.
Tagi rel="prev" i rel="next" nic nie dają. Google ich nie używa przy paginacji. Dla robota to zwykłe linki.
Nofollow nie zamyka strony przed robotem. Strona o mitach mówi, że nofollow wpływa na budżet tylko częściowo. Adres oznaczony nofollow w jednym miejscu robot i tak pobierze, jeśli znajdzie go w innym linku.
Wspólny wniosek: optymalizacja crawl budgetu polega na ograniczeniu liczby zbędnych adresów i przyspieszeniu serwera, nie na dyrektywach dodawanych do stron, które już istnieją.
Jak zwiększyć crawl budget
Google podaje dwa sposoby, czyli tyle, ile da się realnie zrobić.
Pierwszy to więcej zasobów serwera, czyli wyższa wydajność serwera. Dotyczy sytuacji, w której ogranicza was limit wydajności, czyli gdy w Narzędziu do sprawdzania adresu URL widzicie komunikat o przekroczonym limicie obciążenia hosta, a w raporcie Statystyki indeksowania żądania dobijają do linii limitu. Szybszy serwer, cache, CDN dla zasobów statycznych i mniej zapytań do bazy przy generowaniu strony podnoszą limit, bo robot widzi, że serwer wytrzyma więcej.
Drugi to jakość treści. Zapotrzebowanie rośnie, gdy strony są popularne, unikalne i wartościowe dla użytkowników. Tego nie przyspieszy żadna zmiana techniczna.
Czego nie da się zrobić: zamówić częstszego skanowania. Google ma formularz, ale służy on wyłącznie do zgłaszania, że robot skanuje zbyt intensywnie.
Awaryjne spowolnienie robota: 503 i 429
Bywa odwrotnie: robot obciąża serwer w trakcie wyprzedaży albo awarii. Google dopuszcza wtedy zwracanie kodów 500, 503 lub 429 zamiast 200. Ograniczenie działa przez kilka godzin, najwyżej 1-2 dni, i obejmuje cały host, także adresy, które dalej zwracają treść. Jeśli takie kody wracają dłużej niż 2 dni, Google zaczyna usuwać te adresy z indeksu. To hamulec awaryjny, nie sposób na stałe sterowanie robotem.
Jeśli w waszym serwisie każdy z tych punktów wymaga osobnej analizy, a liczba adresów idzie w setki tysięcy, to praca na audyt techniczny w ramach pozycjonowania sklepu internetowego. Przy mniejszych serwisach zwykle wystarcza przegląd opisany w tekście o audycie on-site SEO.
Najczęstsze pytania o crawl budget
1. Czy crawl budget wpływa na pozycje w Google?
Nie bezpośrednio. Google pisze, że skanowanie jest konieczne, żeby strona znalazła się w wynikach, ale nie jest sygnałem rankingowym. Częstsze wizyty robota nie podnoszą pozycji. Problem z budżetem może jednak opóźnić pojawienie się nowych i zmienionych stron w wynikach wyszukiwania.
2. Czy subdomena ma osobny crawl budget?
Tak. Google liczy budżet dla każdej nazwy hosta osobno, więc www.example.com i blog.example.com mają oddzielne budżety.
3. Czy błędy 404 marnują crawl budget?
Nie. Według Google strony zwracające kody 4xx, z wyjątkiem 429, nie marnują budżetu. Kod 404 to dla robota sygnał, żeby nie wracać do adresu. Problemem są natomiast miękkie błędy 404, czyli strony z komunikatem o braku treści, które zwracają kod 200.
4. Czy noindex oszczędza crawl budget?
Nie. Robot musi pobrać stronę, żeby odczytać tag noindex, więc czas skanowania i tak zostaje zużyty. Google wprost odradza używanie noindex do zarządzania budżetem.
5. Czy można ustawić szybkość indeksowania w Search Console?
Już nie. Google wycofał to ustawienie 8 stycznia 2024. Pozostał formularz do zgłaszania zbyt intensywnego skanowania. Zwiększyć szybkości nie da się żadnym ustawieniem.
6. Czy paginacja wpływa na crawl budget?
Każda strona paginacji to osobny adres URL, który robot pobiera jak każdą inną stronę. Google nie używa tagów rel="prev" i rel="next". Paginacja sama w sobie nie jest problemem. Staje się nim, gdy jest jedyną drogą do produktów albo wpisów i robot musi przejść kilkanaście stron listy, żeby do nich dotrzeć.
7. Jak często Googlebot odwiedza stronę?
Google nie podaje stałej częstotliwości. Zależy ona od limitu wydajności serwera i zapotrzebowania na daną witrynę: popularności, rozmiaru i częstotliwości aktualizacji. Strona o mitach zaznacza, że także małe serwisy z często zmienianą treścią są skanowane często. Faktyczną częstotliwość dla waszej witryny pokaże raport Statystyki indeksowania.