
DeepSeek: co to jest, jak działa chiński model AI i dlaczego wstrząsnął rynkiem technologicznym?
DeepSeek to chiński model AI wykorzystujący architekturę Mixture-of-Experts, która aktywuje ułamek parametrów przy każdym tokenie. Rozwija go przedsiębiorstwo badawcze z Hangzhou, założone w 2023 roku i finansowane przez fundusz hedgingowy High-Flyer. Modele wychodzą na licencji MIT, z wagami do pobrania, i są dostępne przez czat webowy, aplikację mobilną oraz API. To właśnie ekonomia treningu zbudowała rozgłos marki: fazę uczenia przez wzmacnianie dla modelu R1 (styczeń 2025) DeepSeek wycenił na 294 tys. USD, a model bazowy V3 na ok. 5,6 mln USD, przy wynikach dorównujących modelowi o1 od OpenAI w matematyce i programowaniu.
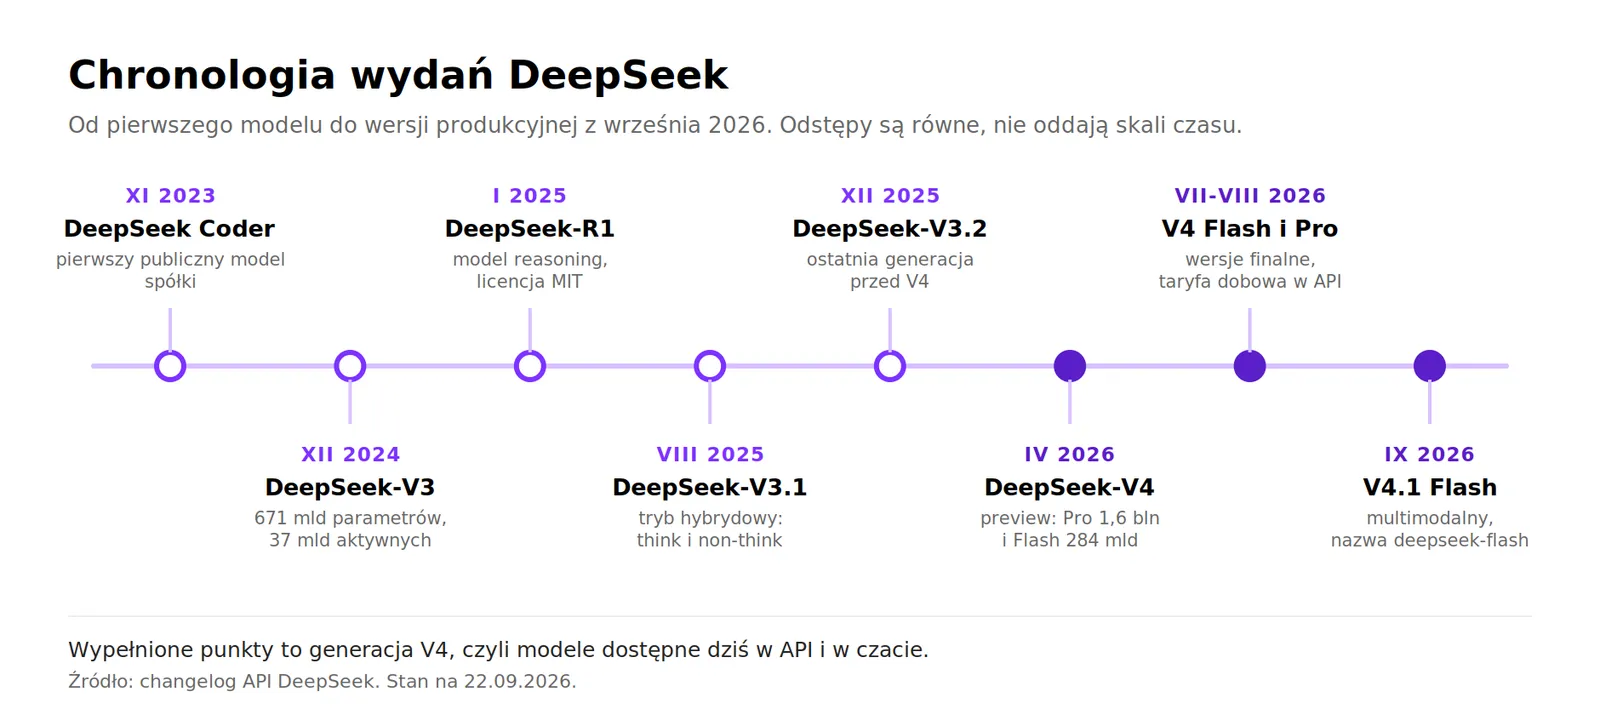
Linię produktową prowadzi dziś generacja V4, udostępniona 24 kwietnia 2026: V4-Pro (1,6 bln parametrów, 49 mld aktywnych na token) i mniejszy V4-Flash, zastąpiony 10 września 2026 przez multimodalny V4.1-Flash. Oba warianty obsługują milion tokenów kontekstu. Czat działa po polsku i jest darmowy, a wagi można uruchomić lokalnie, offline, bez wysyłania danych do chmury. Dwie rzeczy psują ten obraz: oficjalny interfejs cenzuruje tematy politycznie wrażliwe dla Pekinu, a włoski Garante od stycznia 2025 zakazuje przetwarzania danych osobowych Włochów przez platformę.
Czym jest DeepSeek i dlaczego zyskał globalny rozgłos
DeepSeek to duży model językowy (LLM) i cała rodzina modeli rozwijanych przez chińskie przedsiębiorstwo badawcze AI. Model działa na zasadzie open weights: wagi są publicznie dostępne do pobrania, modyfikacji i lokalnego wdrożenia. Globalny rozgłos wynika z trzech czynników: radykalnie niższych kosztów treningu niż u zachodnich gigantów, wyników konkurencyjnych względem GPT czy Gemini oraz decyzji o otwarciu wag na licencji MIT. Ten ostatni punkt odróżnia chiński chatbot AI od zamkniętych ekosystemów OpenAI i Google.
Geneza projektu: Liang Wenfeng i fundusz High-Flyer
Spółka DeepSeek AI wydzieliła się w lipcu 2023 roku w Hangzhou (prowincja Zhejiang) z chińskiego ilościowego funduszu hedgingowego High-Flyer. Fundusz specjalizuje się w handlu algorytmicznym i od lat kupował infrastrukturę GPU do celów tradingowych. Ta baza sprzętowa stała się zapleczem do trenowania modeli AI. Na czele obu podmiotów stoi Liang Wenfeng, inżynier i przedsiębiorca, który założył High-Flyer jeszcze przed erą dużych modeli językowych, a potem przekierował część mocy obliczeniowej funduszu na badania nad AI. Pierwszy publiczny model, DeepSeek Coder, spółka wypuściła w listopadzie 2023.
Pieniądze pochodziły z działalności hedgingowej, nie z venture capital ani z dotacji rządowych. W branży to rzadkość. Częściowo tłumaczy, dlaczego zespół mógł eksperymentować bez presji inwestorów zewnętrznych i bez kwartalnych rozliczeń z wyników.
Wstrząs na Wall Street: wpływ na wycenę Nvidia i spółek technologicznych
W poniedziałek 27 stycznia 2025 roku kurs Nvidii spadł o 16,97 procent i zamknął się na 118,42 USD. Z wyceny spółki wyparowało 589 mld USD, co pozostaje największą jednodniową stratą kapitalizacji w historii amerykańskiej giełdy. Nasdaq Composite stracił tego dnia 3,1 procent, S&P 500 około 1,5 procent, a Broadcom blisko 19 procent.
Wyprzedaż miała konkretny wyzwalacz. Tydzień wcześniej, 20 stycznia, DeepSeek opublikował model R1, a przez weekend jego aplikacja wyprzedziła ChatGPT na liście darmowych aplikacji w amerykańskim App Store. Inwestorzy zestawili to z deklarowanym kosztem treningu poniżej 6 mln USD na osłabionych układach H800 i wyciągnęli wniosek, że amerykańskie koncerny przepłacają za infrastrukturę AI.
Wniosek okazał się przedwczesny. Już nazajutrz akcje Nvidii odbiły o blisko 9 procent, a analitycy JPMorgan i Citi wskazali, że deklarowana kwota obejmuje sam przebieg treningowy, bez wcześniejszych eksperymentów, danych i infrastruktury. Do połowy 2026 roku kurs Nvidii był o około 48 procent wyżej niż w dniu premiery R1, a spółka zamknęła rok obrotowy 2026 rekordowym przychodem 215,9 mld USD. Naszym zdaniem styczniowa przecena była korektą oczekiwań co do kosztu trenowania modeli, a nie co do popytu na GPU, i tak należy ją dziś czytać w analizach rynkowych.
Przełom inżynieryjny: dlaczego DeepSeek był tak tani w trenowaniu
Liczby z tej sekcji dotyczą generacji V3 i R1 z przełomu 2024 i 2025 roku, czyli modeli, które wywołały całe zamieszanie. Trenowanie DeepSeek-V3 pochłonęło ok. 2,788 mln godzin GPU H800, czyli niespełna dwa miesiące ciągłej pracy klastra 2048 układów. Przy stawce ok. 2 USD za godzinę daje to ok. 5,576 mln USD. Po doliczeniu fazy uczenia przez wzmacnianie dla modelu R1 łączny koszt sięga ok. 5,9 mln USD.
Architektura Mixture-of-Experts (MoE) i oszczędność mocy GPU
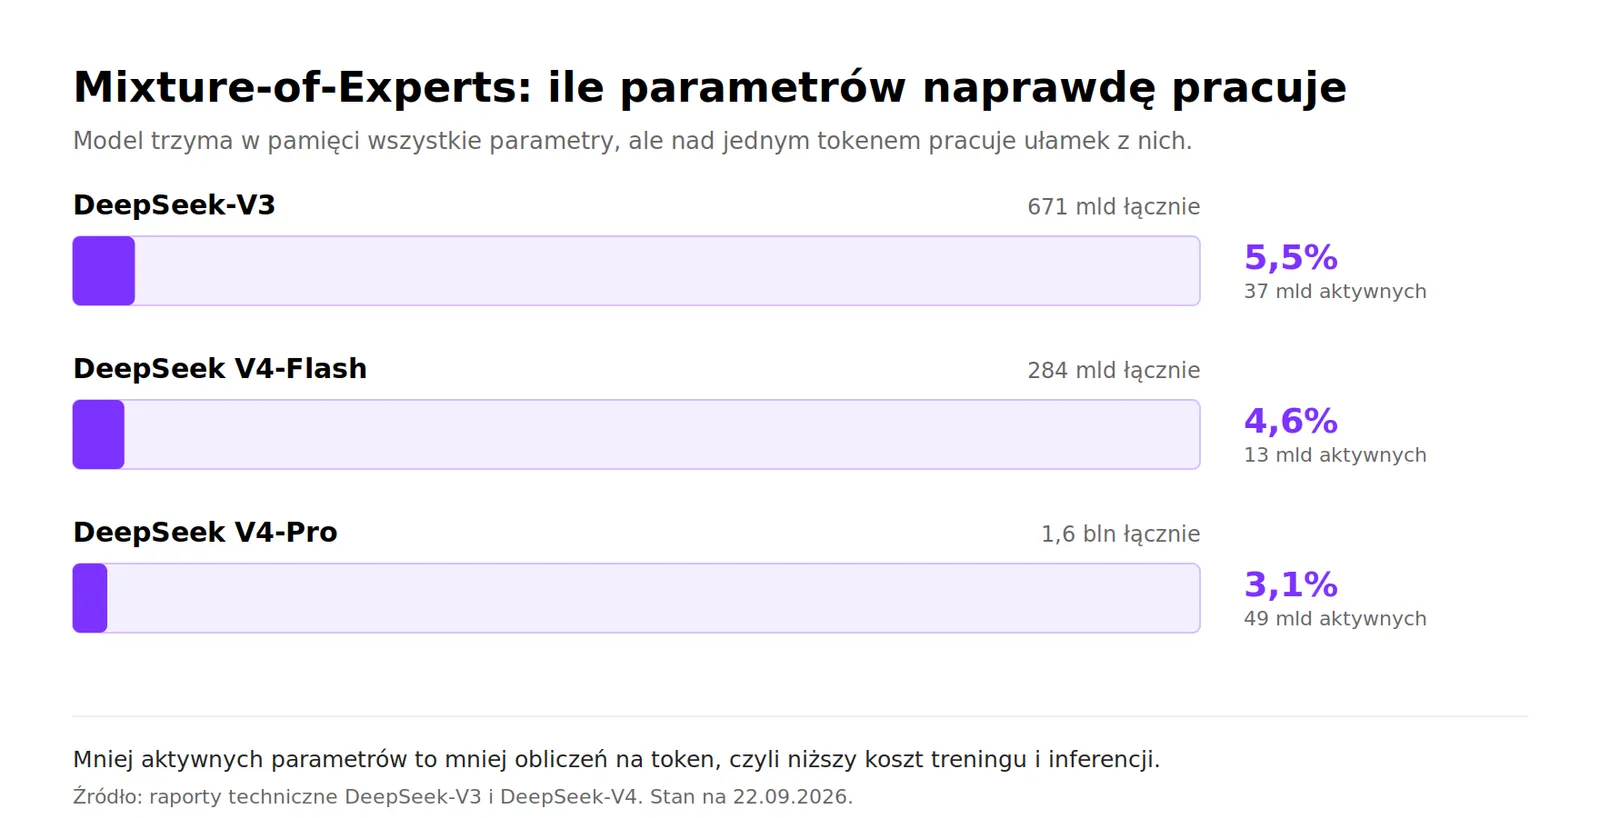
Fundamentem oszczędności jest architektura Mixture of Experts. Model nie aktywuje wszystkich parametrów przy każdym zapytaniu, tylko dynamicznie wybiera podzbiór wyspecjalizowanych „ekspertów" adekwatny do danego tokena.
- Skala parametrów. Model bazowy V3 liczy łącznie ok. 671 mld parametrów, ale w trakcie inferencji aktywuje ok. 37 mld na token, czyli mniej niż 6 procent całości. W generacji V4 proporcja jest jeszcze ostrzejsza: 49 mld z 1,6 bln w wariancie Pro i 13 mld z 284 mld we Flash.
- Ograniczona liczba aktywnych parametrów przekłada się na niższe zużycie energii i krótszy czas treningu. To główny czynnik obniżający koszt modeli tej klasy.
- Dzięki temu trening zmieścił się na klastrze 2048 układów NVIDIA H800, a nie na dziesiątkach tysięcy najnowszych GPU, jak w przypadku modeli trenowanych przez amerykańskie koncerny.
Mechanizm Multi-head Latent Attention (MLA) a pamięć podręczna
Drugą innowacją V3 był Multi-Head Latent Attention: autorski mechanizm uwagi, który kompresuje reprezentacje klucz-wartość (key-value cache) do formy latentnej o niższej wymiarowości, zamiast przechowywać je w pełnej postaci.
Mechanizm MLA w DeepSeek kompresuje cache, obsługując dłuższe konteksty i więcej równoległych zapytań przy tej samej ilości pamięci GPU. To bezpośrednio zmniejsza koszty infrastruktury serwerowej. MLA działa równolegle z Mixture of Experts, więc oszczędności z obu rozwiązań kumulują się w treningu i w inferencji.
Generacja V4 poszła dalej i zastąpiła MLA hybrydową architekturą uwagi, złożoną z Compressed Sparse Attention i Heavily Compressed Attention, wspartą optymalizatorem Muon i mechanizmem mHC w połączeniach rezydualnych. Efekt jest mierzalny: według raportu technicznego V4-Pro potrzebuje ok. 27 procent nakładu obliczeniowego i ok. 10 procent pamięci cache KV w porównaniu z DeepSeek-V3.2 przy generowaniu pojedynczego tokena. To właśnie ta zmiana, a nie samo MoE, uczyniła kontekst miliona tokenów opłacalnym w cenniku API.
Czyste uczenie przez wzmocnienie: innowacja DeepSeek-R1-Zero
Trzecim przełomem jest eksperymentalny model DeepSeek-R1-Zero, wyszkolony wyłącznie metodą uczenia przez wzmacnianie na zasadzie prób i błędów, bez etapu wstępnego nadzorowanego dostrajania (supervised fine-tuning) na danych demonstracyjnych.
- Odejście od standardowego pipeline'u. Tradycyjne modele reasoning uczą się najpierw na przykładach ludzkich rozwiązań, a dopiero potem są dopracowywane przez RL. R1-Zero pominął ten pierwszy krok całkowicie, a jego wynik w AIME 2024 wzrósł w trakcie treningu z 15,6 do 77,9 procent.
- Trening oparto na technice Group Relative Policy Optimization, która porównuje grupy wygenerowanych odpowiedzi względem siebie. Eliminuje to konieczność utrzymywania osobnego modelu wartościującego (critic model).
- Finalny, komercyjny R1 łączy RL z dodatkowym dostrajaniem, by poprawić czytelność i spójność odpowiedzi względem wersji Zero.
Metodologia przeszła recenzję naukową. 17 września 2025 roku opis R1 ukazał się w „Nature", co czyni go pierwszym głośnym modelem językowym zweryfikowanym w procesie peer review renomowanego czasopisma. Przy okazji ujawniono rachunek: 294 tys. USD za trening zdolności wnioskowania, na 512 układach H800 (64 węzły po 8 GPU), ok. 198 godzin dla R1-Zero i ok. 80 godzin dla R1.
Przegląd ekosystemu modeli: od flagowego R1 po generację V4
DeepSeek R1 to model wnioskowania logicznego (reasoning), wydany 20 stycznia 2025 roku i zbudowany na bazie DeepSeek-V3. Generuje długie łańcuchy rozumowania przed podaniem finalnej odpowiedzi w zadaniach matematycznych i programistycznych. Dziś to rozdział zamknięty. Rolę silnika produkcyjnego przejęła generacja V4, a R1 pozostaje dostępny wyłącznie jako otwarte wagi do samodzielnego uruchomienia.
| Model | Charakterystyka | Kluczowe fakty |
|---|---|---|
| DeepSeek-V2 | Wcześniejsza generacja modelu uniwersalnego, poprzednik V3, w której zadebiutowały MoE i kompresja uwagi MLA | Baza koncepcyjna dla optymalizacji rozwijanych w V3; we wrześniu 2024 połączona z linią Coder w wydaniu V2.5 |
| DeepSeek-V3 | Model bazowy typu Mixture-of-Experts ogólnego przeznaczenia, grudzień 2024 | 671 mld parametrów łącznie, ok. 37 mld aktywnych na token, kontekst 128 tys. tokenów; trening ok. 2 miesiące, koszt ok. 5,58 mln USD |
| DeepSeek-R1 | Model wnioskowania logicznego wyspecjalizowany w matematyce i programowaniu | Powstał na bazie V3 przez dodatkową fazę RL; opisany w „Nature" 17 września 2025; koszt fazy RL 294 tys. USD |
| DeepSeek-Coder | Rodzina modeli dedykowanych generowaniu i analizie kodu, wydana w 2023 i 2024 roku | Wchłonięta przez linię uniwersalną w wydaniu V2.5 z września 2024; dziś wyłącznie archiwalne wagi, bez osobnej nazwy w API |
| DeepSeekMath | Wyspecjalizowany model do zadań matematycznych | Tu powstał algorytm GRPO, zastosowany później w treningu R1 |
| DeepSeek-V4 (Flash, Pro) | Aktualna generacja uniwersalna, udostępniona 24 kwietnia 2026 jako preview | V4-Pro: 1,6 bln parametrów, 49 mld aktywnych, wersja finalna 13 sierpnia 2026. V4-Flash: 284 mld i 13 mld aktywnych, wersja finalna 31 lipca 2026. Kontekst 1 mln tokenów, wyjście do 384 tys. |
| DeepSeek-V4.1-Flash | Najmniejszy model nowej rodziny architektonicznej z natywnym rozumieniem obrazu, wydany 10 września 2026 | Zastąpił V4-Flash w API pod nazwą deepseek-flash; stare nazwy deepseek-v4-flash są tymczasowo przekierowywane na ten model |
Licencja jest tu konkretna, nie ogólnikowa. Kod i wagi modeli R1, V3.1, V3.2 oraz całej generacji V4 są publikowane na licencji MIT, która dopuszcza użycie komercyjne, modyfikacje i destylację do trenowania innych modeli. Dwa zastrzeżenia trzeba sprawdzić przed wdrożeniem: pierwotne wydanie V3 z grudnia 2024 rozdzielało licencję kodu (MIT) od osobnej licencji modelu, a warianty destylowane R1 dziedziczą warunki swoich modeli bazowych, czyli Apache 2.0 dla rodziny Qwen2.5 i licencję Meta dla Llamy 3.x. Aplikacje webowa i mobilna pozostają zamknięte.
Sama destylacja wiedzy (knowledge distillation) polega na tym, że mniejsze modele uczą się reprodukować jakość rozumowania modelu nauczycielskiego przy niższych wymaganiach obliczeniowych. Powstałe w ten sposób lżejsze wersje zachowują istotną część zdolności analitycznych oryginału i nadają się do wdrożeń o ograniczonych zasobach sprzętowych.
Sprawdźmy potencjał Twojej strony
Podaj adres swojej strony i e-mail - odezwiemy się z konkretną analizą, bez zobowiązań.
DeepSeek R1 vs ChatGPT o1: bezpośrednie porównanie modeli wnioskujących
To porównanie z początku 2025 roku, gdy oba modele były premierami swoich producentów. Dziś ma wartość historyczną, bo R1 i o1 zostały zastąpione nowszymi generacjami, ale pokazuje mechanizm, który DeepSeek powtarza do dziś: podobny wynik przy nieporównywalnie niższym koszcie i przy otwartych wagach.
Według tabeli z raportu technicznego DeepSeeka R1 uzyskał 79,8 procent w benchmarku AIME 2024 wobec 79,2 procent modelu o1-1217 oraz 97,3 procent w MATH-500 wobec 96,4 procent. Wyniki pochodzą od producenta, nie z niezależnego pomiaru, i tak należy je traktować.
Pierwsza realna różnica dotyczy transparentności procesu myślowego. R1 pokazywał pełny łańcuch rozumowania, użytkownik widział kolejne kroki wnioskowania modelu. o1 ukrywał wewnętrzny łańcuch i prezentował jedynie streszczenie. W generacji V4 DeepSeek utrzymał tę praktykę: w API ślad rozumowania wraca w polu reasoning_content, a w interfejsie webowym jako zwijany blok nad odpowiedzią. Dla zespołów audytujących decyzje modelu to wciąż argument.
Druga różnica to koszt wytworzenia, ujawniony w „Nature". 294 tys. USD za fazę RL, przy nieujawnionych publicznie nakładach OpenAI na trening porównywalnych modeli reasoning.
| Kryterium | DeepSeek R1 | OpenAI ChatGPT o1 |
|---|---|---|
| Wynik AIME 2024 | 79,8 procent | 79,2 procent (o1-1217, pomiar DeepSeeka) |
| Wynik MATH-500 | 97,3 procent | 96,4 procent (o1-1217, pomiar DeepSeeka) |
| Widoczność rozumowania | Pełny, widoczny łańcuch rozumowania | Ukryty łańcuch, prezentowane jedynie podsumowanie |
| Koszt fazy RL | ok. 294 tys. USD (512 układów H800, ok. 80 godzin) | koszt treningu nieujawniony publicznie |
| Model licencjonowania | Otwarte wagi na licencji MIT, wdrożenie on-premise dozwolone | Model zamknięty, dostępny wyłącznie przez API i interfejs OpenAI |
| Status na wrzesień 2026 | Wycofany z API, dostępny jako wagi do pobrania | Zastąpiony nowszymi modelami OpenAI |
Firmy szukające niższych kosztów operacyjnych przy porównywalnej jakości wnioskowania znajdą w modelach DeepSeeka realną alternatywę, pod warunkiem akceptacji różnic w stabilności odpowiedzi i w dostępności wsparcia technicznego, które u OpenAI jest rozbudowane komercyjnie.
Jak korzystać z DeepSeek: oficjalny czat, aplikacja mobilna i model darmowy
DeepSeek jest darmowy dla użytkowników indywidualnych. Podstawowy chatbot nie wymaga opłat ani karty płatniczej, działa przez przeglądarkę oraz aplikacje na iOS i Android, z obsługą języka polskiego. Producent nie publikuje dziennego limitu wiadomości ani płatnego abonamentu dla wersji konsumenckiej. Płatny jest dopiero dostęp do komercyjnego API.
Dostęp przez przeglądarkę i konfiguracja języka polskiego
Interfejs czatu webowego działa pod oficjalnym adresem DeepSeek i nie wymaga instalacji. Wystarczy założyć konto e-mailem lub zalogować się przez Google.
- Rejestracja i logowanie zajmują poniżej minuty. Model automatycznie rozpoznaje język zapytania i odpowiada w tym samym języku, więc polska wersja nie wymaga konfiguracji regionalnej.
- Premiera V4 zastąpiła dawny przełącznik DeepThink dwoma nazwanymi trybami. Instant Mode uruchamia V4-Flash i odpowiada szybko, Expert Mode uruchamia V4-Pro i dłużej rozumuje przed odpowiedzią. Oba mają osobny przełącznik pokazywania toku rozumowania.
- Kontekst miliona tokenów jest aktywny domyślnie, razem z wgrywaniem plików i wyszukiwaniem w sieci. W praktyce można wkleić całą dokumentację i pytać o szczegóły bez dzielenia jej na fragmenty.
- Prompt engineering. W trybie Expert warto formułować pytania wieloetapowo, dzieląc złożony problem na kroki. Pozwala to obserwować proces wnioskowania, a nie tylko finalny wynik.
- Konto webowe synchronizuje historię rozmów między urządzeniami.
Aplikacja mobilna oraz desktopowa na komputer
Aplikacja DeepSeek to natywny klient na iOS i Android, funkcjonalnie odpowiadający wersji webowej.
- Instalacja. Aplikacja jest bezpłatna w App Store i Google Play, a logowanie odbywa się tym samym kontem co w przeglądarce, więc historia czatów synchronizuje się automatycznie. We Włoszech aplikacji nie ma w oficjalnych sklepach od stycznia 2025.
- Wersja mobilna obsługuje wejście głosowe i skanowanie obrazów, na przykład zdjęcie równania lub fragmentu kodu do analizy.
- Wersja desktopowa. Oficjalna aplikacja na Windows i macOS udostępnia te same funkcje co interfejs webowy w osobnym oknie, bez trzymania otwartej karty przeglądarki.
- Rozumienie obrazu jest cechą modelu V4.1-Flash. V4-Pro pozostaje modelem czysto tekstowym, więc analiza zrzutu ekranu trafia do szybszego, nie mocniejszego wariantu.
W okresach największego obciążenia serwerów interfejs potrafi odmówić obsługi komunikatem o zajętości. Dotyczy to zwłaszcza godzin szczytu chińskiej infrastruktury, czyli 01:00-04:00 i 06:00-10:00 czasu UTC w dni robocze.
Cenzura polityczna w interfejsie a neutralność komercyjnego API i wag
Chińskie restrykcje treści dotyczą wyłącznie webowego i mobilnego interfejsu czatu DeepSeek. Tam cenzura obejmuje zapytania polityczne i historyczne wrażliwe dla władz w Pekinie. Komercyjny dostęp przez API oraz lokalnie uruchamiane modele na własnych wagach są wolne od tych filtrów.
Oficjalny czat odmawia odpowiedzi lub wymija pytania o protesty na placu Tiananmen i inne tematy niewygodne dla Pekinu. Filtr działa na poziomie aplikacji, a nie w parametrach modelu, więc jest decyzją produktową dostawcy. Zapytania ucinane w interfejsie czatu mogą być swobodnie przetwarzane lokalnie albo przez surowe wywołania API.
Rozróżnienie ma konsekwencje praktyczne. Deweloperzy korzystający z API Platform i podmioty pobierające otwarte wagi nie napotykają blokad tematycznych obowiązujących w czacie webowym, ale API hostowane w Chinach nadal przepuszcza zapytania i dane przez infrastrukturę dostawcy. Brak cenzury nie oznacza więc braku ryzyka regulacyjnego, a te dwie kwestie mylą się w większości polskich opracowań. Ryzyko prawne opisujemy w sekcji o RODO.
Ekonomia API DeepSeek: koszty tokenów i automatyzacja marketingu cyfrowego
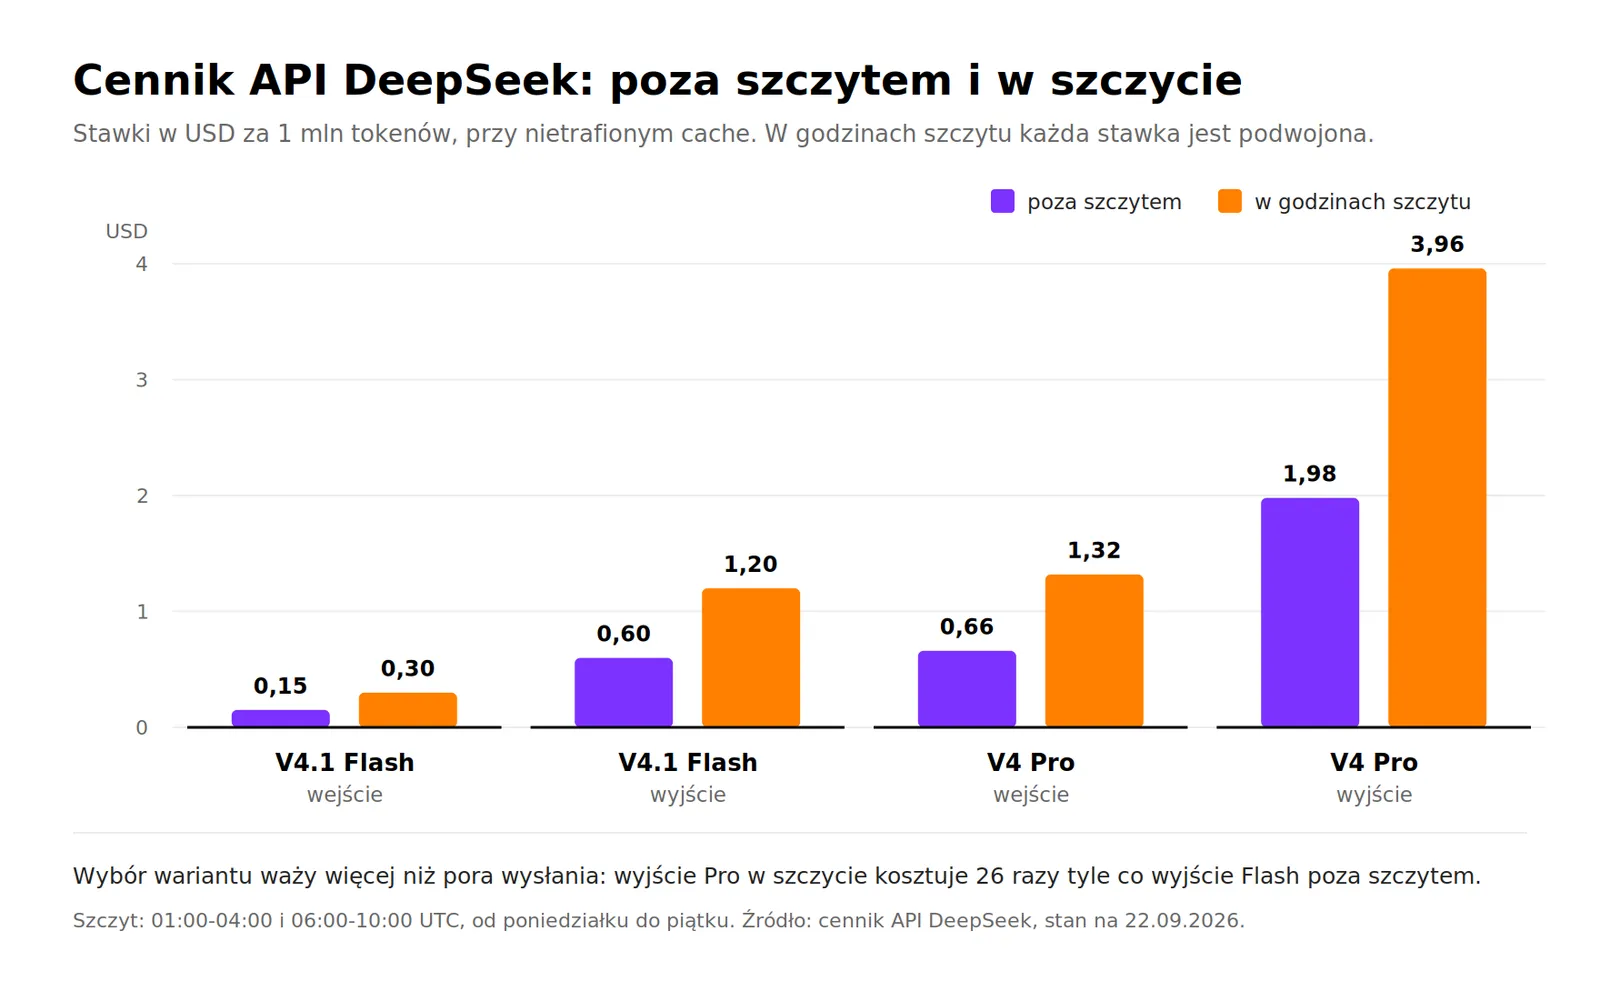
DeepSeek obniża próg rentowności zadań masowego przetwarzania tekstu dzięki niskim cenom tokenów: 0,15 USD za milion tokenów wejściowych i 0,60 USD za milion wyjściowych w wariancie Flash poza godzinami szczytu. Masowe generowanie treści, analiza danych i automatyzacja SEO stają się dzięki temu dostępne dla firm, które wcześniej nie mogły skalować tych procesów przy użyciu generatywnej AI.
Cennik API: porównanie stawek za milion tokenów z konkurencją
API Platform DeepSeek to komercyjny interfejs do integracji z zewnętrznymi aplikacjami. Nie nakłada filtrów ideologicznych i rozlicza się wyłącznie według zużytych tokenów. Od 16 sierpnia 2026 obowiązuje taryfa dobowa: stawki poza szczytem są połową stawek szczytowych, a szczyt przypada na 01:00-04:00 i 06:00-10:00 UTC od poniedziałku do piątku, z wyłączeniem chińskich dni wolnych.
| Model / wariant | Tokeny wejściowe za 1 mln (cache miss) | Tokeny wyjściowe za 1 mln | Uwagi |
|---|---|---|---|
| DeepSeek V4.1 Flash (deepseek-flash) | 0,15 USD poza szczytem, 0,30 USD w szczycie | 0,60 USD poza szczytem, 1,20 USD w szczycie | Najtańszy wariant; trafienie w cache kosztuje 0,003 USD; obsługuje obraz; limit 2500 równoległych zapytań |
| DeepSeek V4 Pro (deepseek-v4-pro) | 0,66 USD poza szczytem, 1,32 USD w szczycie | 1,98 USD poza szczytem, 3,96 USD w szczycie | Wariant do zadań wymagających większej precyzji; tylko tekst; limit 500 równoległych zapytań |
| DeepSeek R1 Reasoner | wycofany | wycofany | Nazwa deepseek-reasoner zniknęła z API 24 lipca 2026; wnioskowanie realizuje dziś tryb thinking w V4 |
| Modele OpenAI (porównawczo) | stawki wyższe o rząd wielkości | stawki wyższe o rząd wielkości | Mnożnik zależy od porównywanego modelu; przed kalkulacją sprawdź aktualny cennik OpenAI |
Podwajanie opłat w szczycie to mechanizm specyficzny dla DeepSeeka. Koszt tego samego zapytania zależy od pory wysłania, co wymusza planowanie zadań masowych poza oknem szczytowym. Różnica potrafi decydować o budżecie: batch na 500 mln tokenów wejściowych to 75 USD poza szczytem i 150 USD w szczycie.
Nie polecamy natomiast opierania biznesplanu na okrągłej liczbie „20 razy taniej niż OpenAI". Relacja cenowa zmienia się przy każdej zmianie cennika po obu stronach, zależy od wariantu modelu, długości kontekstu i skuteczności cache'owania promptu, a od sierpnia 2026 również od godziny wysyłki. Policz koszt na własnym wolumenie.
Zastosowanie w SEO, generowaniu treści i systemach RAG
Niski koszt tokena przesuwa próg rentowności tam, gdzie stawki zachodnich dostawców dotąd czyniły projekt nieopłacalnym.
- Masowe generowanie treści SEO. Przy 0,15 USD za milion tokenów wejściowych opłacalne staje się tworzenie dużych wolumenów opisów produktowych, artykułów kategoryzujących i metadanych bez ograniczania liczby wariantów.
- Systemy RAG (retrieval-augmented generation). Niski koszt tokenów wyjściowych ułatwia budowę pipeline'ów, w których model wielokrotnie odpytuje bazę wiedzy firmy w ramach jednej sesji, na przykład przy odpowiedziach opartych na dokumentacji technicznej. Milion tokenów kontekstu pozwala wrzucić do promptu całe dokumenty zamiast ich fragmentów.
- Generowanie kodu działa w API tak samo jak w czacie, tylko w trybie automatyzowanym, przydatnym przy skryptach integracyjnych i testach jednostkowych.
- Analiza danych tekstowych, od recenzji klientów po logi zapytań, przestaje wymagać próbkowania ze względu na koszt.
- Automatyzacja marketingu cyfrowego. Integracja API z CMS i narzędziami kampanijnymi pozwala generować warianty nagłówków i opisów reklam dopasowane do segmentów odbiorców, bez ręcznej pracy copywriterów przy każdej iteracji. Firmy budujące widoczność w wyszukiwarkach generatywnych traktują to jako element pozycjonowania AI, nie jako zamiennik strategii.
Wariant Flash sprawdza się w zadaniach powtarzalnych i wysokoobjętościowych. Pro kosztuje ponad czterokrotnie więcej za tokeny wejściowe, więc sens ma tam, gdzie liczy się precyzja wnioskowania: w analizie danych finansowych czy generowaniu kodu o wysokiej złożoności logicznej.
Prywatność, RODO i wdrożenia lokalne on-premise
Firmy objęte RODO mogą ominąć ryzyko chińskiej jurysdykcji chmurowej, wdrażając otwarte wagi DeepSeek we własnej infrastrukturze. Wagi można pobrać bezpłatnie i uruchomić lokalnie, bez przesyłania danych do zewnętrznej chmury. To odpowiedź na pytanie „czy DeepSeek jest bezpieczny": bezpieczeństwo zależy od miejsca wdrożenia, a nie od samego modelu.
Skala nadzoru regulacyjnego jest dobrze udokumentowana. Włoski Garante 30 stycznia 2025 roku nakazał spółkom Hangzhou DeepSeek Artificial Intelligence i Beijing DeepSeek Artificial Intelligence ograniczenie przetwarzania danych osobowych osób przebywających we Włoszech, po tym jak odpowiedzi firmy uznał za niewystarczające, a sama firma podważyła właściwość włoskiego organu. Decyzja nie została uchylona i obowiązuje do dziś; aplikacja zniknęła z włoskich sklepów, choć wersja webowa pozostała dostępna. Według analizy IAPP z lutego 2026 postępowania toczyły się w trzynastu europejskich jurysdykcjach, a Europejska Rada Ochrony Danych powołała osobną grupę zadaniową do egzekwowania przepisów wobec AI. Odrębny wątek zamknął włoski urząd antymonopolowy AGCM 30 kwietnia 2026 roku, przyjmując zobowiązania DeepSeeka, Mistrala i NOVA AI do wyraźniejszego ostrzegania użytkowników o ryzyku halucynacji.
Uruchamianie modeli offline przez Ollama i LM Studio
DeepSeek udostępnia otwarte wagi, które użytkownicy mogą uruchamiać lokalnie bez pisania kodu od zera. Użytkownicy wdrażają modele DeepSeek za pomocą dwóch popularnych narzędzi:
- Ollama to narzędzie konsolowe do zarządzania modelami lokalnie. Pobiera skwantyzowaną wersję modelu jedną komendą i wystawia ją przez lokalne API kompatybilne z formatem OpenAI, co pozwala podpiąć istniejące aplikacje bez zmiany kodu klienta. Wsparcie dla nowych architektur DeepSeeka pojawia się tu z opóźnieniem względem llama.cpp, więc dostępność konkretnej wersji sprawdź przed planowaniem wdrożenia.
- LM Studio to aplikacja desktopowa z interfejsem graficznym, która pozwala przeglądać, pobierać i testować modele z repozytorium Hugging Face bez znajomości linii komend. Przydaje się zespołom oceniającym jakość odpowiedzi przed decyzją produkcyjną.
Źródłem wag jest Hugging Face: stamtąd pochodzą oficjalne wydania i społecznościowe kwantyzacje, pliki GGUF dla obu narzędzi oraz safetensors dla wdrożeń serwerowych. We wszystkich trzech ścieżkach inferencja odbywa się w całości na sprzęcie użytkownika, bez połączenia z internetem po pobraniu modelu. Dla firm objętych RODO oznacza to, że dane wejściowe nigdy nie opuszczają sieci lokalnej.
Wymagania sprzętowe, pamięć VRAM i techniki kwantyzacji
Kwantyzacja redukuje precyzję liczbową wag, na przykład z 8 bitów do 3, zmniejszając rozmiar pliku i wymagania pamięciowe kilkukrotnie, kosztem niewielkiego spadku jakości odpowiedzi. Bez niej modele DeepSeeka wymagają sprzętu serwerowego.
- V4-Flash (284 mld parametrów). W oryginalnej precyzji ok. 175 GB pamięci, w kwantyzacji 8-bitowej ok. 162 GB, w 3-bitowej ok. 103 GB. Ta ostatnia wersja startuje na maszynie ze 110 GB pamięci łącznej, na przykład na Macu z pamięcią unified, ale to nadal sprzęt daleko poza przeciętną stacją roboczą.
- V4-Pro (1,6 bln parametrów). Wymaga wielokartowego serwera Blackwell albo klastra H200. Wdrożenie realne wyłącznie na dedykowanej infrastrukturze.
- Warianty destylowane R1 (7B, 8B, 14B, 32B, 70B) pozostają jedyną ścieżką dla pojedynczej karty konsumenckiej z 8-24 GB VRAM. Są słabsze od generacji V4, ale to one odpowiadają za większość realnych wdrożeń on-premise w mniejszych firmach.
Uczciwa uwaga na koniec: samodzielny hosting rzadko wygrywa na rachunku kosztów. Przy stawce 0,15 USD za milion tokenów wejściowych wynajem GPU zwraca się dopiero przy bardzo dużych, stałych wolumenach. Argumentem za lokalnym wdrożeniem jest kontrola nad danymi i brak zależności od chińskiej infrastruktury, a nie oszczędność, i tak radzimy uzasadniać ten wydatek przed zarządem. Firmy planujące wykorzystanie AI w procesach treściowych, w tym w ramach strategii pozycjonowania AI, zwykle zaczynają od wariantów skwantyzowanych jako kompromisu między kosztem sprzętu a jakością treści.
FAQ
Najkrócej: DeepSeek to chińska spółka badawcza, jej modele są otwarte na licencji MIT i darmowe w czacie, płatne w API, a ryzyko prawne zależy od tego, czy używasz chmury dostawcy, czy własnego serwera.
Czym dokładnie jest DeepSeek?
DeepSeek to chińskie przedsiębiorstwo badawcze AI, wydzielone w lipcu 2023 roku w Hangzhou z funduszu hedgingowego High-Flyer, kierowane przez Lianga Wenfenga. Rozwija rodzinę otwartych modeli językowych opartych na architekturze Mixture-of-Experts, dostępnych przez czat webowy, aplikację mobilną i API. Aktualna linia to V4-Pro i V4.1-Flash, wcześniejsze generacje to V3 i R1.
Czy korzystanie z DeepSeek jest bezpłatne?
Czat webowy i aplikacja mobilna są bezpłatne, bez abonamentu i bez publicznie deklarowanego limitu wiadomości. Wagi modeli można darmowo pobrać i uruchomić lokalnie. Płatne jest komercyjne API: od 0,15 USD za milion tokenów wejściowych i 0,60 USD za milion wyjściowych w wariancie Flash poza godzinami szczytu, z podwojeniem stawek w szczycie.
Na jakiej licencji udostępniane są modele DeepSeek?
Kod i wagi modeli R1, V3.1, V3.2 oraz generacji V4 są objęte licencją MIT, która dopuszcza użycie komercyjne, modyfikacje i destylację. Wyjątki dotyczą pierwotnego wydania V3 z osobną licencją modelu oraz wariantów destylowanych R1, dziedziczących warunki modeli bazowych Qwen2.5 i Llama. Aplikacje konsumenckie pozostają zamknięte.
Czy DeepSeek poprawnie obsługuje język polski?
Tak, modele rozpoznają język zapytania i odpowiadają w tym samym języku, bez dodatkowej konfiguracji. Producent nie publikuje osobnych benchmarków dla polszczyzny, więc jakość w zadaniach specjalistycznych warto sprawdzić na własnych promptach przed wdrożeniem.
Czy DeepSeek jest bezpieczny pod kątem RODO i prywatności danych?
Wersja chmurowa podlega chińskiej jurysdykcji i cenzuruje wątki polityczne, a we Włoszech obowiązuje zakaz przetwarzania danych osobowych wydany przez Garante w styczniu 2025 roku. Dla firm objętych RODO bezpieczniejszą opcją jest lokalne wdrożenie otwartych wag na własnej infrastrukturze, gdzie dane nie opuszczają sieci organizacji.