
Leonardo AI - co to jest, jak działa i ile kosztuje generator obrazów?
Stan na 25 września 2026. Leonardo wymienia modele i zmienia cennik kilka razy w roku, więc przed zakupem sprawdźcie aktualną listę silników i ceny na leonardo.ai. Nie jesteśmy partnerem ani przedstawicielem Leonardo, piszemy z pozycji agencji, która narzędzia tego typu testuje na własnych materiałach.
Leonardo AI to platforma do generowania obrazów, wideo i tekstur 3D z opisu tekstowego lub zdjęcia, zbudowana przez Leonardo Interactive Pty Ltd z Sydney i przejęta przez Canvę 30 lipca 2024 roku (Canva Newsroom). Jej sensem nie jest jeden model, tylko jeden panel, w którym obok autorskich silników Leonardo stoją modele Google, OpenAI i Black Forest Labs.
Podstawowy dostęp jest darmowy, w przeglądarce oraz w aplikacjach na iOS i Androida. Płatne plany zaczynają się od 12 USD miesięcznie i odblokowują prywatność generacji, trenowanie własnych modeli i wyższe limity tokenów.
Tworzenie grafik na podstawie opisów tekstowych przestało być w 2026 roku wyróżnikiem, bo robi to każde większe narzędzie sztucznej inteligencji. Różnicę robi to, co jest wokół generatora: edycja, powtarzalność i prawa do wyniku.
Poniżej opisujemy, jak wygląda praca w panelu, które modele są dziś dostępne, ile realnie kosztuje regularna produkcja grafik i gdzie narzędzie naszym zdaniem się broni, a gdzie nie.
Leonardo AI - co to jest i na czym polega jego wielomodelowa architektura
Leonardo AI to chmurowe studio graficzne, w którym jedna subskrypcja daje dostęp do kilkunastu silników generatywnych przełączanych w tym samym oknie. Firmę założono w grudniu 2022 roku w Sydney, a w lipcu 2024 roku kupiła ją Canva, deklarując, że Leonardo będzie rozwijane dalej jako osobna platforma. W komunikacie o przejęciu Canva podała dwie liczby: ponad 19 milionów użytkowników produktów Leonardo i zespół 120 osób (Canva Newsroom, 30.07.2024). Nowszych danych o skali platformy Leonardo ani Canva nie publikują, a liczby krążące po zestawieniach narzędzi AI nie mają wskazanego źródła, więc ich nie powtarzamy.
Na ekranie startowym widać, że generowanie obrazów to tylko jeden z modułów. Obok niego stoją Video, Audio, 3D, Upscaler oraz Blueprints i Agent. Blueprints to gotowe ścieżki zamykające kilka kroków w jeden formularz: Leonardo uruchomiło je z ponad pięćdziesięcioma szablonami, część z nich wypada poza dobową pulę konta darmowego ze względu na koszt w tokenach (Centrum pomocy Leonardo). Agent jest oznaczony jako beta. Ten tekst dotyczy obrazu, wideo i tekstur 3D, bo to one mają dla nas zastosowanie w pracy agencji; modułu audio nie testowaliśmy i nie opisujemy go na podstawie cudzych materiałów.
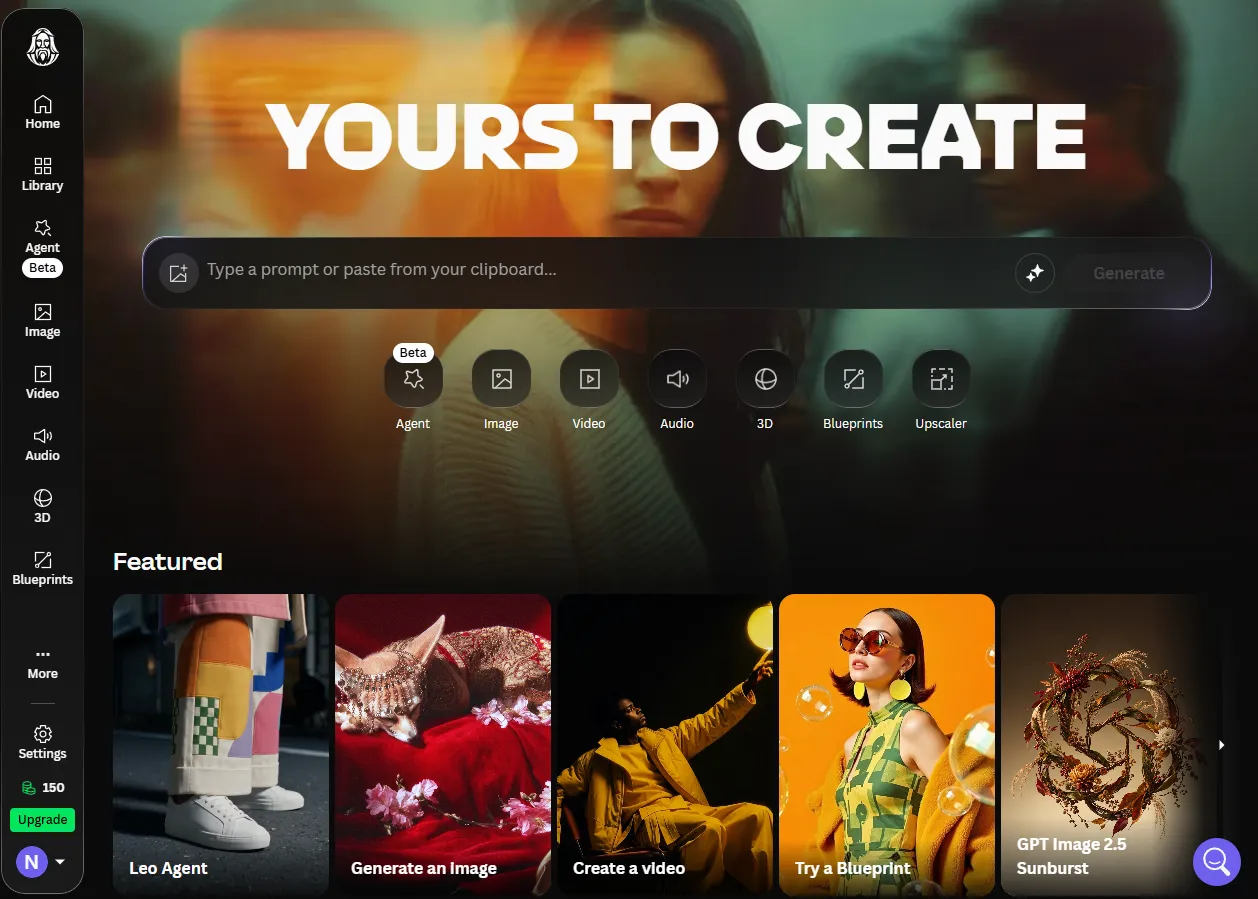
Ekran startowy, 22 września 2026. Wybór modułu poprzedza wybór silnika: selektor modeli otwiera się dopiero po wejściu w Image. Licznik w lewym dolnym rogu pokazuje 150 tokenów, czyli dobową pulę planu darmowego.
Rdzeń autorski to dziś rodzina Lucid: Lucid Origin jako model ogólnego przeznaczenia i Lucid Realism nastawiony na fotorealizm i fakturę analogową. Phoenix 1.0, pierwszy własny model fundamentalny Leonardo z 2024 roku, nadal jest na liście, ale w roli silnika od ścisłego trzymania się instrukcji, nie flagowca (Leonardo, przewodnik po modelach obrazu).
Obok nich w tym samym selektorze stoją modele zewnętrzne. Poniżej zrzut listy z panelu, bo to ona, a nie dokumentacja, mówi, co jest dostępne dzisiaj.
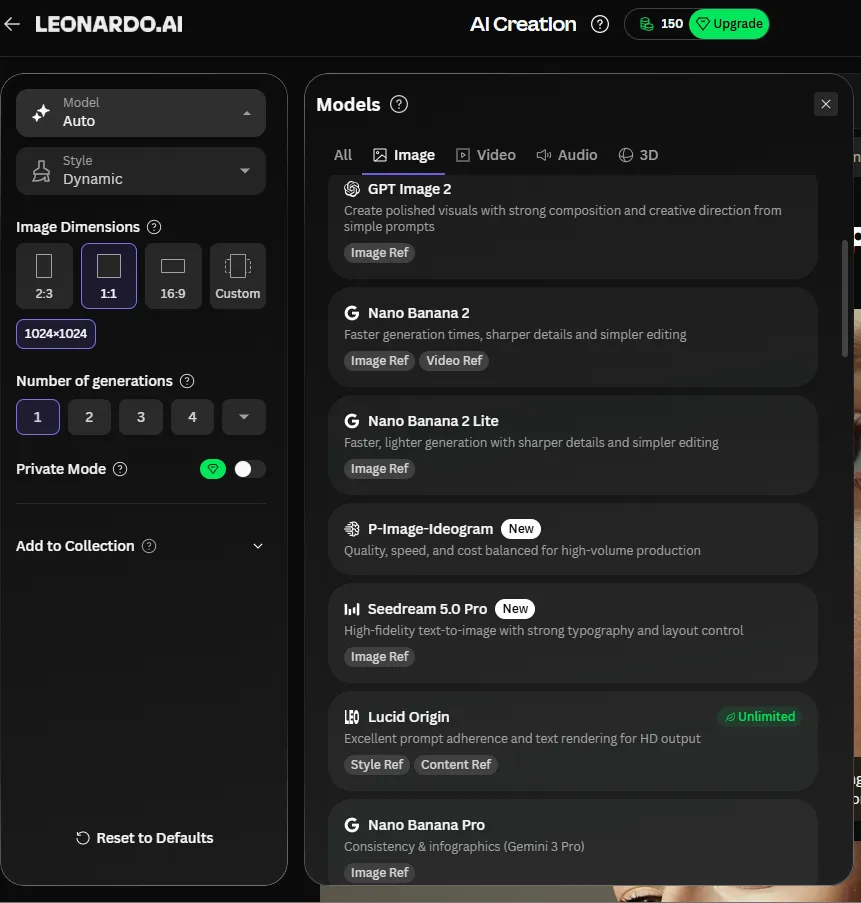
Selektor modeli, 22 września 2026. Lista jest dłuższa niż widoczny fragment i dzieli się na zakładki dla obrazu, wideo, audio i 3D. Po lewej ustawienia generowania: model, styl, proporcje kadru, liczba wariantów i przełącznik trybu prywatnego.
Z Google są tu Nano Banana 2, Nano Banana 2 Lite oraz Nano Banana Pro, opisany w panelu jako silnik do spójności i infografik zbudowany na Gemini 3 Pro. Z OpenAI GPT Image 2, wskazywany do dopracowanych kompozycji z krótkiego promptu. Do tego Seedream 5.0 Pro z naciskiem na typografię i układ, P-Image-Ideogram do produkcji wysokowolumenowej oraz Lucid Origin oznaczony jako Unlimited, czyli objęty trybem nielimitowanym.
Ten fragment pokazuje, jak szybko starzeją się takie zestawienia. Przewodnik po modelach na stronie Leonardo, aktualizowany 9 marca 2026, wymienia jeszcze GPT Image 1.5, Seedream 4.0 i Ideogram 3.0. W panelu we wrześniu są już GPT Image 2, Seedream 5.0 Pro i P-Image-Ideogram. Gdy dokumentacja producenta rozjeżdża się z interfejsem, wierzcie interfejsowi, a przy każdym poradniku sprawdzajcie datę.
Warto wiedzieć, czego na tej liście już nie ma. Kino XL i modele Stable Diffusion, które w poradnikach sprzed dwóch lat opisywane są jako baza Leonardo, zniknęły z zestawienia silników generujących. SDXL został wyłącznie jako baza do trenowania własnych Elementów, o czym piszemy niżej. Jeśli trafiacie na instrukcję krok po kroku z nazwą Kino XL, jest przestarzała.
Platforma działa jako serwis webowy bez instalacji oraz jako aplikacje mobilne. Wersje na iOS i Androida wydaje Leonardo Interactive Pty Ltd i synchronizują się z tym samym kontem, więc projekt zaczęty na komputerze można kontynuować na telefonie (App Store, Google Play).
Jak działa generator obrazów Leonardo AI w praktyce? Poradnik krok po kroku
Praca z generatorem przebiega w czterech etapach: wybór modułu i silnika, konfiguracja parametrów technicznych, wprowadzenie promptu wraz z promptem negatywnym i iteracyjna korekta wyniku. Moduł Image Generation zamienia opis tekstowy w obraz, a presety stylistyczne ustawiają za was głębię ostrości, oświetlenie i kolorystykę.
Konfiguracja parametrów generacji i dobór silnika
Przed wygenerowaniem obrazu w panelu bocznym ustawia się zestaw parametrów, które decydują o charakterze i powtarzalności wyniku:
- Silnik generatywny - wybór modelu przesądza o stylu bardziej niż cokolwiek innego. Leonardo sam sugeruje dobór pod zadanie: Lucid Realism do mockupów produktowych i portretów, Nano Banana Pro do infografik z tekstem, Flux Dev do trenowania własnych stylów, Flux Schnell do szybkich szkiców przed dopracowaniem.
- Guidance Scale - określa, jak dosłownie model realizuje treść promptu. Niższe wartości dają modelowi więcej swobody interpretacyjnej, wyższe wymuszają ścisłe odwzorowanie opisu.
- Seed - liczba inicjująca generowanie. Ten sam seed z tym samym promptem i tymi samymi ustawieniami pozwala odtworzyć identyczny albo zbliżony wynik, co jest kluczowe przy pracy nad spójną serią.
- Liczba wariantów i rozdzielczość - decydują, ile propozycji powstaje w jednym zapytaniu i w jakiej jakości. To one najmocniej przekładają się na zużycie tokenów.
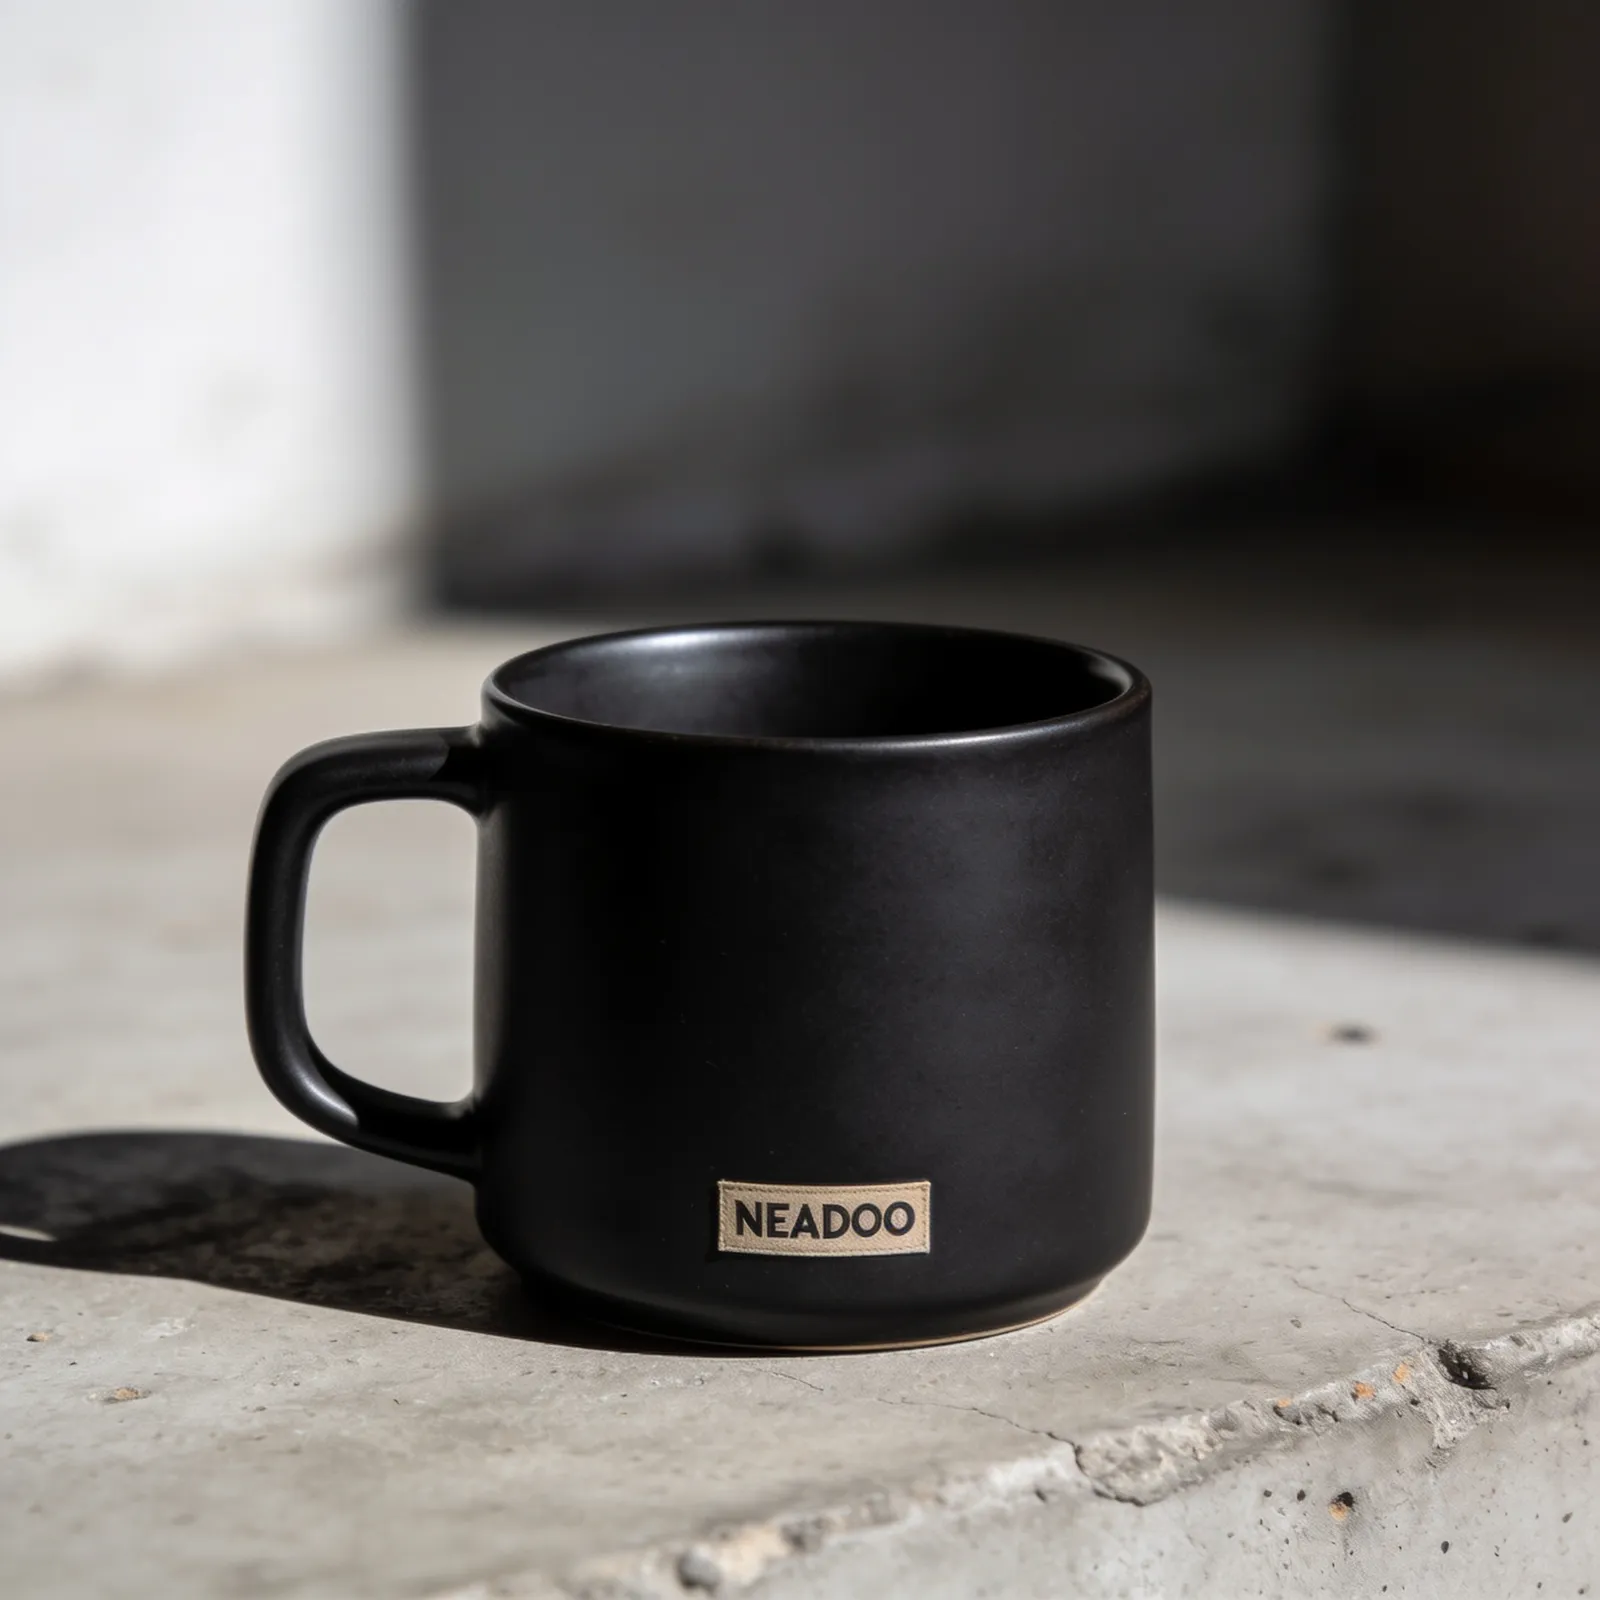
Żeby pokazać, ile realnie zmienia sam wybór silnika, puściliśmy ten sam prompt przez cztery modele 22 września 2026. Prompt był dosłownie taki: product photo of a matte black ceramic coffee mug on a concrete surface, side light from the left, shallow depth of field, small printed label reading „NEADOO" on the mug, studio photography, 4k. Żadnych zmian między przebiegami poza modelem.
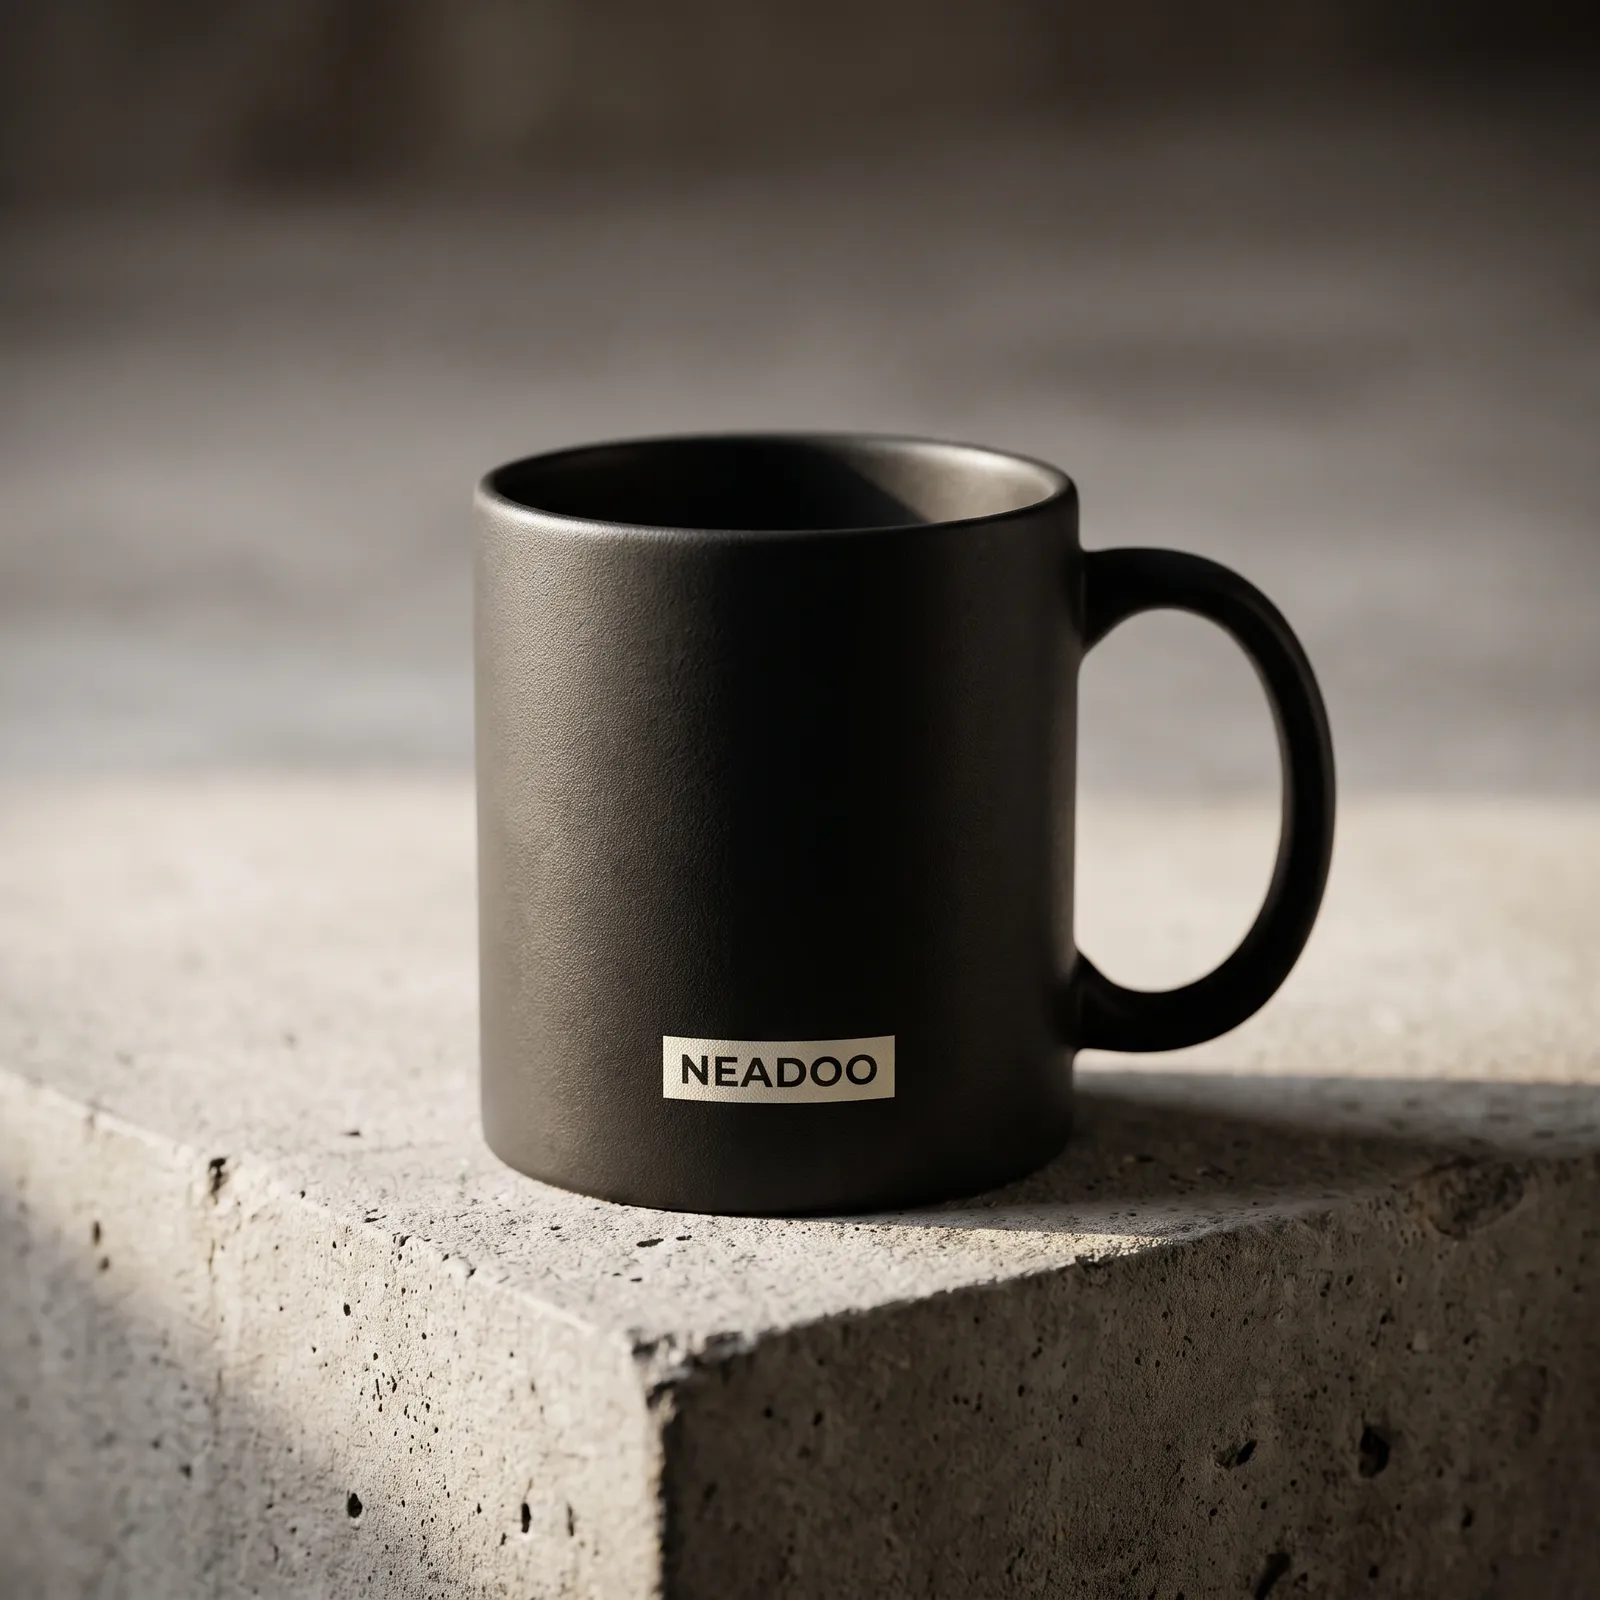
Nano Banana Pro. Najbliżej promptu: twarde światło boczne, beton z widocznym kruszywem i wykruszoną krawędzią, etykieta zrobiona jako nadruk na prostokątnym polu. Wynik w 2048 na 2048 pikseli.
Seedream 4.5. Ta sama rozdzielczość 2048 na 2048, ale „printed label" zinterpretowane jako naszywka z materiału, z obszyciem i fakturą tkaniny. Ostrzejszy kontrast i czytelny kierunek światła.
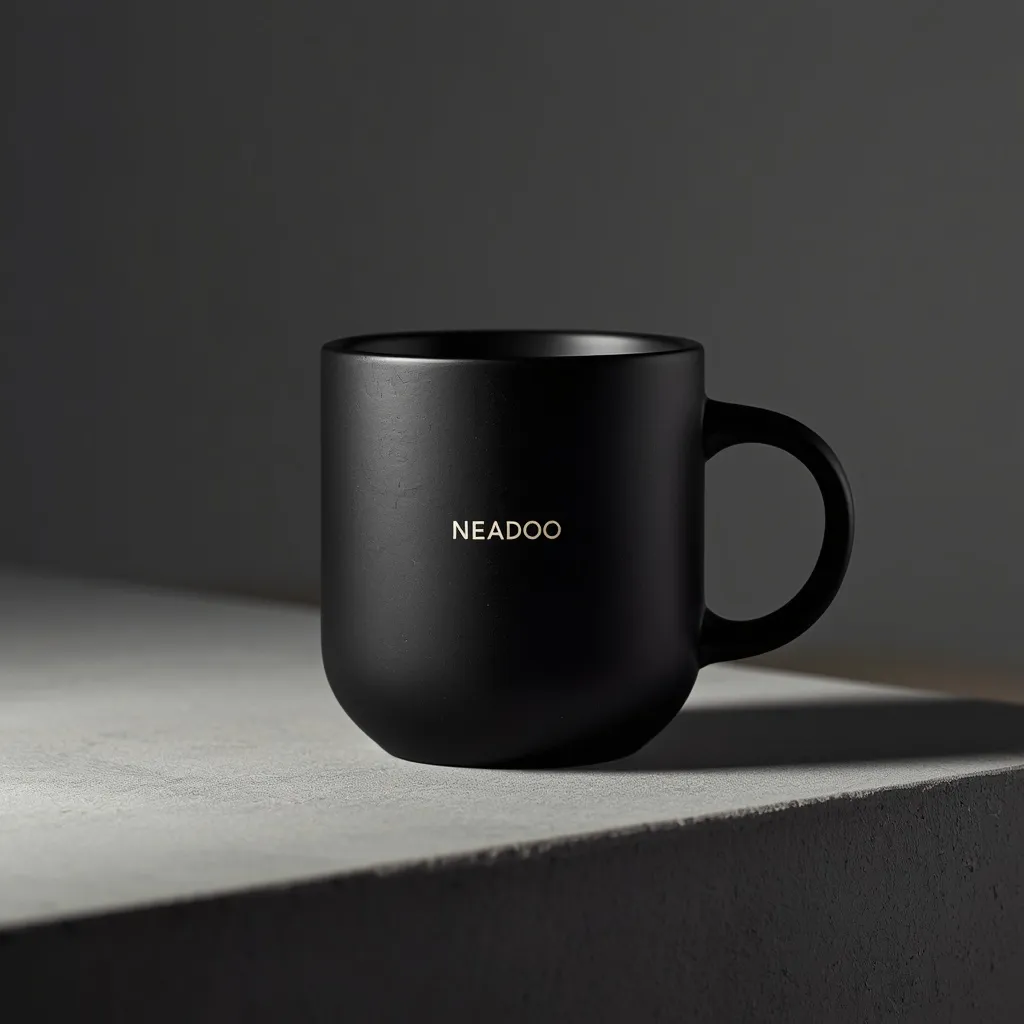
Lucid Origin. Etykiety nie ma wcale, jest złocony napis wprost na ceramice. Najbardziej studyjny kadr z czterech, ale też najdalszy od briefu, bo prompt prosił o etykietę. Rozdzielczość 1024 na 1024.
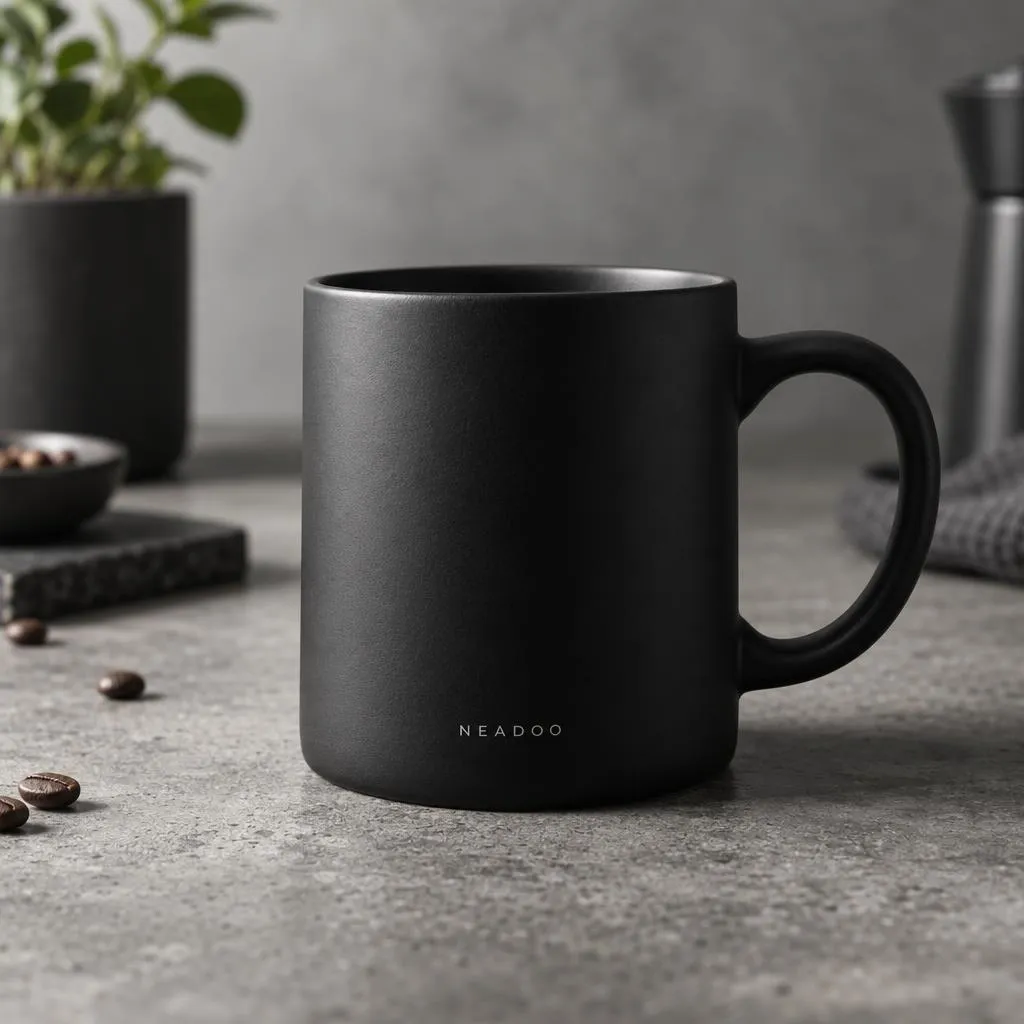
GPT Image 2.5. Jedyny wynik, który dołożył rekwizyty spoza promptu: roślinę, ziarna kawy, kawiarkę i ściereczkę. Ładne zdjęcie lifestyle'owe, tyle że nikt o nie nie prosił, a beton zamienił się w kuchenny blat.
Wnioski z tej czwórki są dwa i oba idą wbrew temu, czego się spodziewaliśmy. Po pierwsze, wszystkie cztery poprawnie napisały NEADOO. Renderowanie krótkiego tekstu na produkcie przestało różnicować modele i nie jest już argumentem przy wyborze silnika, choć większość poradników nadal tak je sprzedaje.
Po drugie, różnice przebiegają przez interpretację promptu, nie przez jakość obrazu. Wszystkie cztery obrazy są technicznie dobre. Rozjeżdżają się na tym, co model uznał za „małą drukowaną etykietę": raz nadruk, raz naszywka, dwa razy sam tekst bez etykiety. Przy zdjęciach produktowych to jest właśnie ta różnica, która decyduje, ile rund poprawek zjecie, zanim dostaniecie kadr do akceptacji. Nasz wniosek do pracy komercyjnej: im bardziej wynik ma odpowiadać konkretnemu briefowi, tym mniej opłaca się model, który dokłada od siebie.
Osobnym trybem jest Flow State, pomyślany pod szybkie szukanie kierunku, a nie pod dopracowywanie jednego kadru. Wpisujecie prompt, przewijacie strumień obrazów, a przy tym, który się spodobał, klikacie „More Like This”, żeby dostać jego warianty. Kosztuje 1 token za wygenerowany obraz, działa też na koncie darmowym, a przełącznik „Scroll to Generate” ogranicza porcję do ośmiu obrazów naraz, żeby nie spalić puli w kilka minut (Centrum pomocy Leonardo).
Promptowanie w praktyce: język angielski i prompty negatywne
Przewidywalny efekt zależy od precyzyjnego opisu obiektu, stylu, oświetlenia i kompozycji kadru. Modele najlepiej interpretują frazy angielskie, bo na anglojęzycznych danych były trenowane. Promptowanie po polsku działa, ale bywa mniej precyzyjne przy złożonych opisach technicznych i przy nazwach stylów artystycznych. W naszej praktyce prościej jest pisać prompt po angielsku niż tłumaczyć potem, dlaczego model zrobił coś innego.
Prompty negatywne eliminują niepożądane elementy:
- zniekształcenia anatomiczne, na przykład nieprawidłową liczbę palców czy kończyn,
- zbędne artefakty graficzne i szumy,
- barwy lub tekstury niezgodne z zamierzoną stylistyką.
Uwaga praktyczna: prompt negatywny nie działa jednakowo we wszystkich silnikach. Modele instrukcyjne pokroju Nano Banana czy GPT Image reagują raczej na polecenie opisane w zwykłym promptcie niż na osobną listę wykluczeń.
Postprodukcja w Leonardo AI: Canvas Editor i Universal Upscaler
Canvas Editor i Universal Upscaler zdejmują z was potrzebę otwierania zewnętrznego programu graficznego przy typowych poprawkach. Inpainting, rozszerzanie kadru i podnoszenie rozdzielczości odbywają się w panelu.
Canvas Editor obsługuje inpainting, czyli zaznaczenie pędzlem fragmentu i zastąpienie go nową treścią bez ruszania reszty obrazu, oraz outpainting, czyli dogenerowanie sceny poza pierwotnym kadrem, przydatne przy zmianie formatu z kwadratu na baner. Do tego dochodzi tryb Img2Img, w którym wgrane zdjęcie staje się bazą modyfikacji stylistycznych, oraz Sketch to Image, w którym punktem wyjścia jest odręczny szkic. Edytor rozróżnia maskowanie od wymazywania: maska zachowuje część tego, co jest pod spodem, a wymazanie usuwa fragment do czysta. Sama dokumentacja ostrzega, że obrazy po upscalingu edytuje się trudniej, więc poprawki nanoście przed powiększaniem, nie po (Centrum pomocy Leonardo).
Usuwanie tła jest w Leonardo osobnym narzędziem, nie funkcją Canvasa. Warto o tym wiedzieć, bo API remove.bg, także należące do Canvy, przenosi się do Leonardo z dniem 1 grudnia 2026 roku, a dotychczasowe kredyty remove.bg wtedy wygasają (Leonardo, remove.bg API is Moving to Leonardo.Ai, 28.08.2026). Jeśli macie u siebie integrację z remove.bg, to termin do odnotowania niezależnie od tego, czy używacie Leonardo do grafiki.
Osobnym trybem edycji jest Realtime Canvas. To narzędzie Image to Image, w którym rysujecie w oknie, a model przelicza kolejne pociągnięcia pędzla w czasie rzeczywistym, korzystając z Latent Consistency Model. Suwak Creativity Strength decyduje, jak blisko trzymać się szkicu, presety stylu zastępują rozbudowany prompt, a Instant Refine dociąga wynik do 1024 na 1024 piksele. Szkic można też wgrać z dysku zamiast rysować go w panelu (Centrum pomocy Leonardo). W praktyce agencyjnej to najszybsza droga od układu na kartce do poglądowej wizualizacji, na przykład przy ustalaniu kompozycji banera przed właściwym generowaniem.
Universal Upscaler podnosi rozdzielczość i dogenerowuje mikroszczegóły, ostrość i faktury przy powiększaniu grafiki do formatów druku. Działa zarówno na obrazach z panelu, jak i na plikach wgranych z dysku (dokumentacja Leonardo). Tu jedna uwaga z doświadczenia: upscaler rekonstruuje detal, więc dodaje informację, której w oryginale nie było. Przy zdjęciach produktowych, w których liczy się zgodność z rzeczywistym wyrobem, trzeba to sprawdzać kadr po kadrze.
Wysokorozdzielcze grafiki przydają się też w treściach, które przygotowujecie pod pozycjonowanie AI, bo materiał wizualny wchodzi do indeksu razem z tekstem. To argument za jakością pliku, nie za zalewaniem artykułu grafikami.
Sprawdźmy potencjał Twojej strony
Podaj adres swojej strony i e-mail - odezwiemy się z konkretną analizą, bez zobowiązań.
Budowanie spójności marki: jak wytrenować własny model i zachować powtarzalność postaci
Leonardo pozwala douczyć model na własnym zbiorze grafik, dzięki czemu kampania zachowuje jedną estetykę, a bohater serii wygląda tak samo na każdej kreacji. Funkcja nazywa się dziś Elements (LoRA) i Datasets, a liczba własnych modeli jest limitowana planem: 10 w Essential, 20 w Premium, 50 w Ultimate (cennik Leonardo).
Dokumentacja podaje konkretne widełki zbioru treningowego, inne niż popularne w poradnikach „10 do 20 grafik”:
- Liczba ujęć - minimum 10 obrazów. Maksimum zależy od bazy: 50 przy Flux Dev, 40 przy SDXL.
- Baza treningowa - Flux Dev do fotorealizmu, ujęć kinowych i podobieństwa postaci, SDXL do postaci stylizowanych. Lightning XL dokumentacja odradza wprost.
- Zróżnicowane światło i kadr - przy trenowaniu podobieństwa postaci Leonardo zaleca od 8 do 12 zdjęć kadrowanych blisko twarzy, w różnym oświetleniu, pod różnym kątem i z różną mimiką. To ważne, bo intuicja podpowiada odwrotnie: zbiór z jednym, powtarzalnym światłem uczy model oświetlenia, a nie postaci.
- Spójny format - jednolity styl, format i rozmiar plików, najlepiej 1024 na 1024 piksele.
Trening trwa od około 30 minut do kilku godzin, zależnie od liczby obrazów i ustawień (Centrum pomocy Leonardo).
Praktyczna korzyść dotyczy przede wszystkim powtarzalnej postaci reprezentującej markę: maskotki, wirtualnego ambasadora, bohatera serii kreacji. Bez douczonego modelu każda kolejna generacja tej samej postaci różni się drobiazgami w rysach twarzy, proporcjach i kolorze oczu. Przy kilku grafikach to nie problem, przy kilkudziesięciu banerach i postach robi się z tego wizualna niekonsekwencja, którą widać w feedzie.
Ta sama logika działa przy serii grafik produktowych. Douczony model trzyma jedno światło i jedną stylistykę na przestrzeni całej kampanii, więc banery reklamowe i posty w social media wyglądają jak jeden zestaw, a nie jak zbiór przypadkowych generacji. Sprawdza się to zwłaszcza w e commerce, gdzie ten sam produkt trzeba pokazać w kilkunastu ujęciach i formatach.
Animacja i wideo marketingowe: Motion 2.0, Veo 3.1 i reszta stawki
Moduł wideo zamienia statyczną grafikę albo wgrane zdjęcie w krótki klip. Materiałem wejściowym może być obraz wygenerowany w panelu lub własna fotografia, a silnik dokłada do niej ruch, zachowując pierwotną kompozycję.
Autorski model Leonardo nazywa się Motion 2.0 i jest pomyślany pod szybkość i kontrolę: daje konkretne sterowanie kamerą, czyli pan, zoom i tilt, i nadaje się do krótkich, chwytliwych zapętleń oraz testowania ujęć. Domyślnym modelem wideo na platformie jest dziś Hailuo 2.3, chwalony przez Leonardo za radzenie sobie z fizyką ruchu (Leonardo, przewodnik po modelach wideo).
Modele Google są w Leonardo, ale w nowszej wersji, niż powtarza większość poradników: to Veo 3.1 i Veo 3.1 Fast, wskazywane do pracy reklamowej, w której produkt musi wyglądać tak samo przez całe ujęcie. Obok nich stoją Kling 3.0 i 3.0 Turbo z ujęciami wieloplanowymi, Seedance 2.5 z transferem ruchu i obsługą 4K, FLUX 3 Video generujący do 20 sekund wielosceniowego materiału z dźwiękiem oraz LTX-2 do spokojnych, filmowych ujęć. Sora 2 i Sora 2 Pro zostały z Leonardo usunięte w lipcu 2026 roku po zmianie po stronie OpenAI, a jako zamiennik Leonardo wskazuje właśnie Veo 3.1.
Kilkusekundowe klipy pionowe wpisują się w formaty TikToka, Instagram Reels i YouTube Shorts. Uczciwie: to materiał na teaser, przebitkę albo wariant testowy, a nie na kampanię wizerunkową, w której klient rozpozna, że nikt niczego nie nakręcił.
Teksturowanie modeli 3D z plików OBJ
Leonardo przyjmuje siatki 3D w formacie OBJ i nakłada na nie wygenerowaną teksturę. Dokumentacja stawia dwa twarde warunki: akceptowany jest wyłącznie plik z rozszerzeniem .obj, a model musi mieć rozłożone mapowanie UV, bez tego tekstura się nie wygeneruje (dokumentacja Leonardo). Dla jednego modelu można wygenerować wiele tekstur i porównać warianty.
Teksturowanie przebiega na tej samej zasadzie co generowanie grafik 2D: opisujecie materiał, na przykład „zmatowioną skórę z widocznymi przetarciami” albo „polerowany metal ze śladami korozji”, a algorytm generuje mapę zgodną z układem UV modelu.
Zastosowania są dwa i oba niszowe. W gamedevie proceduralna tekstura skraca drogę do prototypu, zanim ktokolwiek otworzy Substance Paintera. W e-commerce pozwala pokazać warianty materiałowe tego samego produktu, na przykład jedną sylwetkę obuwia w skórze, zamszu i tkaninie technicznej, bez fotografowania każdej wersji. Zastrzeżenie jest takie samo jak przy upscalerze: to wizualizacja koncepcyjna, nie odwzorowanie konkretnej partii towaru, więc do karty produktu w sklepie nadaje się dopiero po weryfikacji.
Leonardo AI czy Midjourney? Porównanie możliwości, wygody i kontroli
Różnica między tymi platformami jest dziś mniejsza, niż sugerują poradniki pisane w 2023 roku, i przebiega gdzie indziej. Leonardo wygrywa liczbą silników pod jedną subskrypcją i trenowaniem modeli na własnych plikach. Midjourney wygrywa domyślną estetyką: z krótkiego promptu, bez grzebania w ustawieniach, dostajecie obraz, który wygląda lepiej.
Dwa argumenty, które krążą po sieci, są nieaktualne i nie warto na nich budować decyzji. Po pierwsze, Midjourney nie wymaga już Discorda: aplikacja webowa działa od sierpnia 2024 roku i ma własny edytor z inpaintingiem, outpaintingiem i zmianą kadru. Po drugie, Midjourney ma wideo: model Video V1 animuje obraz przyciskiem Animate od czerwca 2025 roku. Aktualna linia modeli obrazu to V8, rozwijana przez cały 2026 rok, z osobnym modelem do edycji obrazu dodanym w sierpniu 2026 (changelog Midjourney).
Prawdziwe różnice wyglądają tak:
| Kryterium | Leonardo AI | Midjourney |
|---|---|---|
| Wybór silników | Kilkanaście modeli obrazu i wideo, własnych i zewnętrznych, w jednym selektorze | Wyłącznie własny model, linia V8 |
| Interfejs | Aplikacja webowa, aplikacje na iOS i Androida | Aplikacja webowa oraz Discord |
| Edycja obrazu | Canvas Editor: inpainting, outpainting, Img2Img, Sketch to Image | Edytor webowy: inpainting, outpainting, zmiana kadru |
| Własne modele | Elements (LoRA) i Datasets trenowane na waszych plikach, 10 do 50 modeli zależnie od planu | Profile Personalization i moodboardy, bez treningu LoRA na własnym zbiorze |
| Wideo | Motion 2.0, Veo 3.1, Kling 3.0, Seedance 2.5, Hailuo 2.3 i inne | Video V1, animacja z obrazu |
| Tekstury 3D | Tak, z plików OBJ z mapowaniem UV | Nie |
Rynek nie kończy się na tych dwóch platformach, ale porównania też trzeba przeformułować. Modele OpenAI, kiedyś wskazywane jako alternatywa pod nazwą DALL-E 3, dziś nazywają się GPT Image i są dostępne zarówno w ChatGPT, jak i wewnątrz Leonardo. Realną alternatywą pozostaje Adobe Firefly, osadzony w Creative Cloud i sprzedawany na podstawie licencjonowanych danych treningowych, co bywa argumentem w rozmowie z działem prawnym klienta.
Cennik Leonardo AI, darmowe tokeny i prawa komercyjne
Konto darmowe odnawia 150 tokenów dziennie, a bank tokenów zatrzymuje się na 150, więc niewykorzystana pula nie kumuluje się przez tydzień. Generacje z planu darmowego są publiczne. Prywatność, wyższe limity i trenowanie własnych modeli zaczynają się od 12 USD miesięcznie (cennik Leonardo).
Token jest jednostką rozliczeniową zużywaną przy generowaniu, upscalingu i trenowaniu modelu. W planie darmowym pula odnawia się dobowo, w płatnych jest miesięczna i uzupełniana bankiem tokenów.
Zestawienie planów indywidualnych
Ceny poniżej pochodzą z cennika Leonardo i podane są bez podatku, przy rozliczeniu miesięcznym. Rozliczenie roczne obniża je o maksymalnie 20 procent.
| Plan | Cena miesięczna | Tokeny na miesiąc (bank) | Generacje | Własne modele |
|---|---|---|---|---|
| Free | 0 USD | 150 dziennie (bank 150) | publiczne | brak |
| Essential | 12 USD | 8 500 (bank 25 500) | prywatne | 10 |
| Premium | 30 USD | 25 000 (bank 75 000) | prywatne | 20 |
| Ultimate | 60 USD | 60 000 (bank 180 000) | prywatne | 50 |
Poziomy różnią się też liczbą równoległych generacji: 2 w Essential, 3 w Premium, 6 w Ultimate, oraz kolejką, której w Essential nie ma wcale. Tryb Relaxed, czyli nielimitowane generowanie w wolniejszym tempie na wybranych modelach, zaczyna się dopiero od Premium i obejmuje tam wyłącznie obraz. Nielimitowane wideo w tym trybie jest tylko w Ultimate. To istotne, bo właśnie ten zapis najczęściej myli się w zestawieniach: plan za 12 USD nie ma nielimitowanych generacji w żadnej formie.
Dla zespołów Leonardo ma osobne plany: Starter za 72 USD miesięcznie przy 24 USD za stanowisko i Growth za 144 USD miesięcznie przy 48 USD za stanowisko, oba z pulą tokenów dzieloną przez zespół. Trenowanie modeli z tokenów zespołowych jest dostępne dopiero w Growth. Dla integracji jest też API w modelu pay as you go.
Stare nazwy planów, czyli Apprentice, Artisan i Maestro, nadal wracają w poradnikach i zestawieniach. Odpowiadają kolejno planom Essential, Premium i Ultimate. Jeśli widzicie w tekście Apprentice albo Maestro, patrzycie na materiał sprzed zmiany nazewnictwa i reszta liczb w nim też może być nieaktualna.
Prawa autorskie, prywatność grafik i wykorzystanie komercyjne
Tu przebiega najważniejsza granica między planem darmowym a płatnym i nie jest nią samo prawo do sprzedaży.
Na koncie darmowym można tworzyć i pobierać grafiki do celów komercyjnych. Haczyk jest inny: generacje trafiają do publicznej galerii i nie da się tego wyłączyć, a Leonardo zastrzega sobie wobec treści publicznych bezterminowe, światowe prawo do ich używania, kopiowania, przetwarzania i tworzenia opracowań. Inni użytkownicy widzą wasze projekty i mogą je remiksować (Centrum pomocy Leonardo, Commercial Usage).
Plany płatne dają tryb prywatny, a przy generacjach prywatnych użytkownik zachowuje pełną własność i pełne prawa komercyjne do wyników. To jest realny powód, dla którego praca dla klienta wymaga planu płatnego: nie tyle sama licencja, ile prywatność projektów. Kreacja przygotowana pod kampanię nie ma prawa wisieć w publicznej galerii, zanim klient ją zobaczy, a w wersji darmowej nie da się tego wyłączyć.
Trzecia rzecz, o której trzeba pamiętać niezależnie od planu: odpowiedzialność za prompt i za to, czy wynik nie narusza cudzych praw, jest po waszej stronie. Wpisanie w prompt nazwiska żyjącego ilustratora albo nazwy cudzej marki nie staje się bezpieczne dlatego, że narzędzie je wykonało.
Najczęstsze pytania o Leonardo AI
1. Czy Leonardo AI jest całkowicie darmowe?
Nie. Działa w modelu freemium: konto darmowe dostaje 150 tokenów dziennie, ale generacje są publiczne, brakuje trenowania własnych modeli i wyższych ustawień jakości. Pełne funkcje odblokowują subskrypcje od 12 USD miesięcznie, a aplikacje mobilne dodatkowo oferują zakupy wewnątrz aplikacji.
2. Czy mogę legalnie sprzedawać grafiki wygenerowane w Leonardo AI?
Tak, komercyjne wykorzystanie jest dozwolone także na koncie darmowym. Różnica dotyczy własności i prywatności: grafiki z planu darmowego są publiczne, a Leonardo zachowuje wobec nich szerokie prawa do używania i przetwarzania. Przy generacjach prywatnych w planach płatnych pełne prawa zostają po stronie użytkownika, dlatego do pracy dla klienta rekomendujemy minimum plan Essential.
3. Czym Leonardo AI różni się od Midjourney?
Leonardo daje dostęp do kilkunastu silników obrazu i wideo pod jedną subskrypcją, w tym modeli Google i OpenAI, oraz pozwala wytrenować własny model na waszych plikach. Midjourney pracuje na jednym własnym modelu z linii V8 i wygrywa domyślną estetyką przy krótkim promptcie. Nieaktualne jest natomiast twierdzenie, że Midjourney wymaga Discorda albo nie ma wideo: aplikacja webowa działa od 2024 roku, a model Video V1 od 2025.
4. Jakich modeli wideo można używać w Leonardo AI?
Domyślnym modelem jest Hailuo 2.3, autorskim silnikiem Leonardo Motion 2.0 ze sterowaniem kamerą, a z modeli zewnętrznych dostępne są między innymi Veo 3.1 i Veo 3.1 Fast od Google, Kling 3.0 i 3.0 Turbo, Seedance 2.5, FLUX 3 Video oraz LTX-2. Sora 2 została z platformy usunięta w lipcu 2026 roku.
5. Ile grafik potrzeba, żeby wytrenować własny model w Leonardo AI?
Minimum to 10 obrazów, maksimum zależy od bazy treningowej: 50 przy Flux Dev i 40 przy SDXL. Przy trenowaniu podobieństwa postaci dokumentacja zaleca od 8 do 12 zdjęć kadrowanych blisko twarzy, w różnym świetle, pod różnym kątem i z różną mimiką. Trening trwa od około 30 minut do kilku godzin.
6. Czy Leonardo AI działa po polsku?
Interfejs i prompty przyjmują polski, ale modele trenowano głównie na danych anglojęzycznych, więc przy złożonych opisach technicznych i nazwach stylów angielski prompt daje przewidywalniejszy wynik. To różnica w precyzji, nie w dostępności funkcji.
7. Czy Leonardo AI należy do Canvy?
Tak. Canva ogłosiła przejęcie 30 lipca 2024 roku i zadeklarowała, że Leonardo będzie działać dalej jako osobna platforma z własnym rozwojem produktu. W praktyce tak jest do dziś: subskrypcja, panel i modele Leonardo są niezależne od konta Canvy.
8. Czego nie wrzucać do Leonardo AI?
Na koncie darmowym nie wrzucajcie niczego, czego nie chcecie pokazać obcym, bo generacje trafiają do publicznej galerii bez możliwości wyłączenia. Niezależnie od planu poza narzędzie nie powinny wychodzić: niepublikowane materiały klienta objęte umową o poufności, zdjęcia osób, które nie wiedzą, że ich wizerunek trafia do generatora, dane osobowe w promptach oraz cudze grafiki wgrywane jako referencja do treningu. Przy pracy dla klienta warto zapytać, czy jego umowa w ogóle dopuszcza przetwarzanie materiałów w zewnętrznych narzędziach sztucznej inteligencji, bo część branż ma to wprost zakazane.
Źródła
- Leonardo.Ai, cennik planów indywidualnych, zespołowych i API
- Leonardo's AI Image Models Explained, aktualizacja 09.03.2026
- AI Video Generation Models: What to Use & When, aktualizacja 10.08.2026
- Upscale with Universal Upscaler - dokumentacja Leonardo.Ai
- Welcome to Canva, Leonardo! - Canva Newsroom, 30.07.2024
- Leonardo.ai - hasło w Wikipedii, data założenia i lista współzałożycieli
- Leonardo.Ai - Image Generator, App Store
- Leonardo.Ai - Image Generator, Google Play
- remove.bg API is Moving to Leonardo.Ai - Leonardo.Ai, 28.08.2026