
Linki kanoniczne (rel="canonical") - czym są, jak działają i jak je poprawnie wdrożyć?
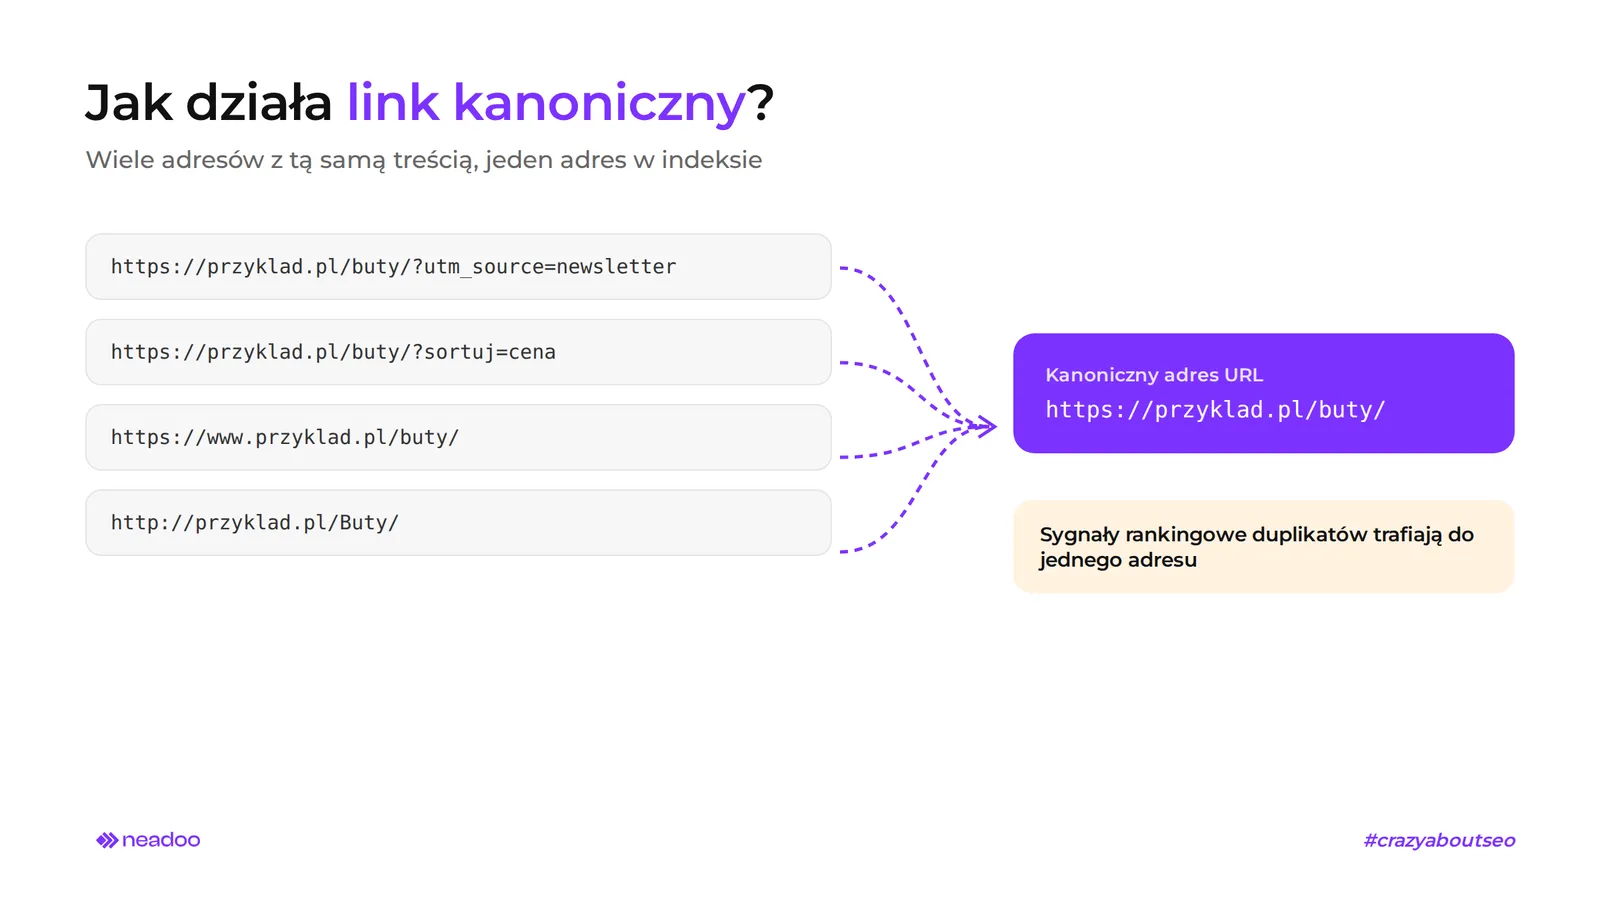
Gdy Google indeksuje kilka wersji tej samej podstrony, np. z parametrami sortowania, filtrami albo z „www” i bez, sygnały rankingowe rozkładają się między duplikaty, a wyszukiwarka sama decyduje, którą wersję pokazać w wynikach. Linki kanoniczne rozwiązują ten problem, bo za ich pomocą wskazujemy wyszukiwarce, który adres URL strony jest właściwy. To znacznik HTML umieszczany w sekcji , który wskazuje robotom Google preferowany adres URL spośród duplikatów. Proces wyboru takiej wersji to kanonizacja adresów URL. Jej efekt: sygnały z wielu adresów trafiają do jednego, a duplikacja treści przestaje rozmywać widoczność.
Tag kanoniczny jest dla Google wskazówką, nie poleceniem. Z artykułu dowiesz się, jak działa znacznik canonical, jak ustawić link kanoniczny zgodnie z dokumentacją Google Search Central (łącznie z self-referencing canonical) i jak sprawdzić wdrożenie w praktyce. Najwięcej miejsca poświęcamy stosowaniu linków kanonicznych w sklepach internetowych, bo tam nawigacja fasetowa generuje setki niemal identycznych adresów.
Co to jest link kanoniczny i dlaczego ma kluczowe znaczenie dla SEO?
Link kanoniczny (canonical) to element w kodzie HTML, który służy do informowania wyszukiwarek, jaki jest kanoniczny adres URL dla stron o identycznej lub bardzo podobnej treści. Dzięki niemu wyszukiwarki wiedzą, którą wersję strony indeksować i pokazywać w wynikach wyszukiwania. Duplikaty nadal działają, ale wyszukiwarki indeksują tylko preferowaną wersję. Nie opisuje zawartości strony, jak title czy meta description. Zarządza relacjami między duplikatami. Bez tej deklaracji Google uznaje za kanoniczny URL ten adres, który sam oceni jako najbardziej reprezentatywny, i bywa, że trafia na adres z parametrem UTM albo wersję testową zamiast strony, na której firma buduje widoczność.
Duplikacja treści rozprasza sygnały rankingowe: linki przychodzące i dane o zachowaniu użytkowników rozkładają się między warianty URL. Znacznik canonical łączy ten rozproszony link juice i przypisuje go do wskazanego adresu. Google potwierdza, że kanoniczny adres URL jest dla niego głównym źródłem oceny treści i jakości, a duplikaty skanuje rzadziej. W przypadku treści powielanych celowo, np. na blogach z wersjami do druku, w sklepach z filtrami i serwisach z wieloma wariantami adresów canonical chroni też przed kanibalizacją słów kluczowych.
Stosowanie linków kanonicznych to jeden z podstawowych elementów optymalizacji SEO. Użytkownik tego znacznika nie widzi. Błędna kanonizacja potrafi jednak obniżyć widoczność całych sekcji serwisu, nawet gdy treść jest dobra.
Jak poprawnie wdrożyć tag rel="canonical" w kodzie HTML?
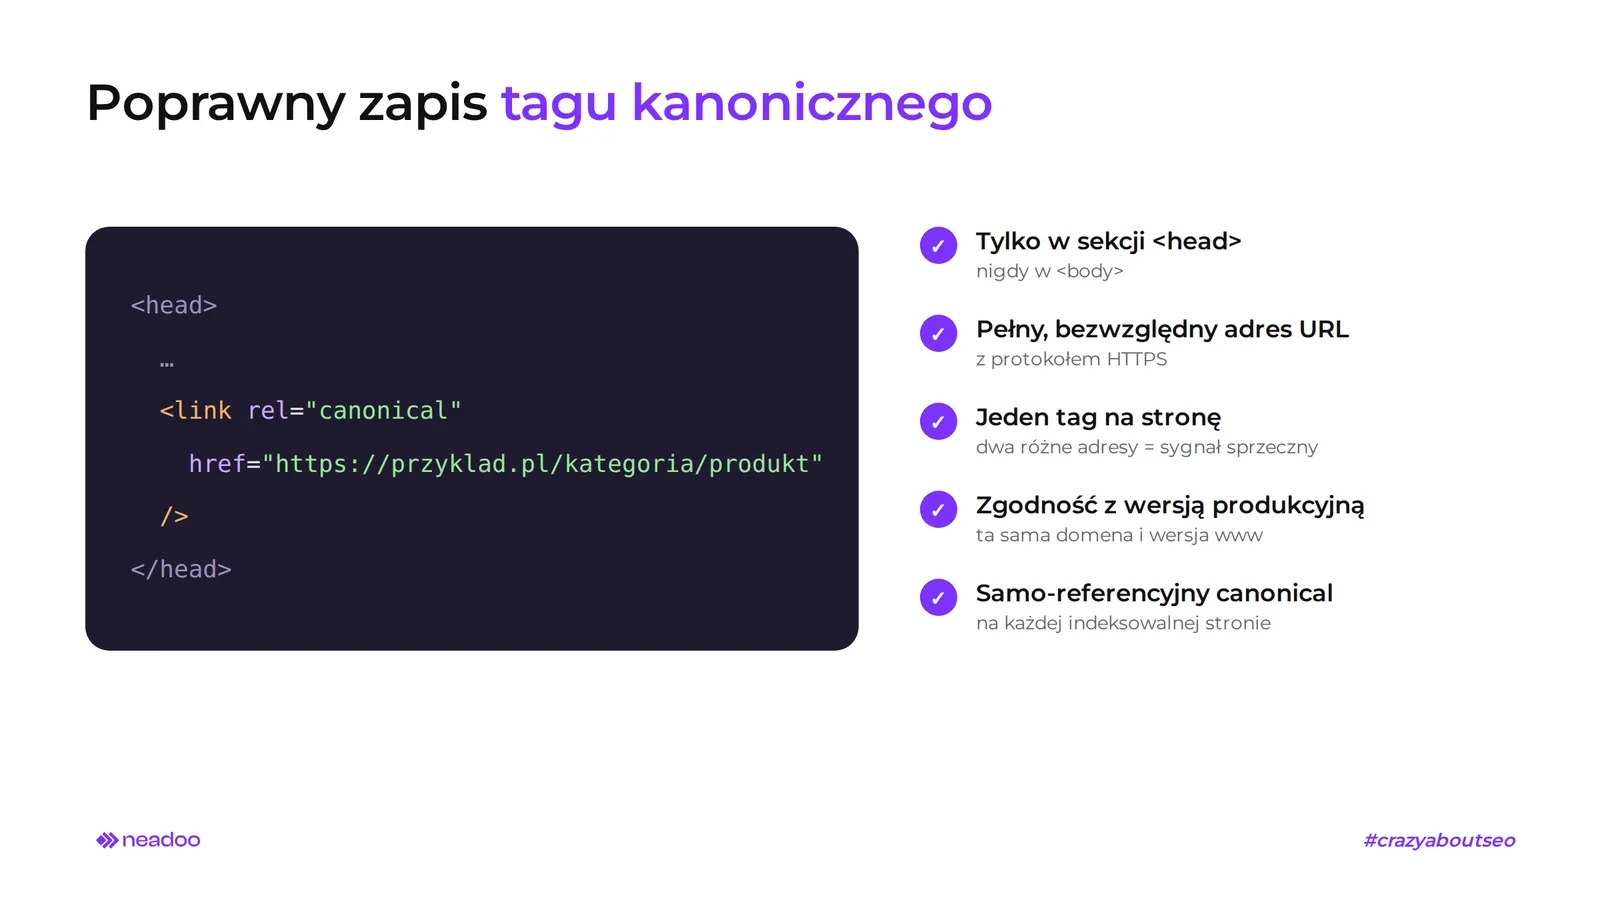
Tag kanoniczny umieszcza się wyłącznie w sekcji strony, jako pełny, bezwzględny adres URL z protokołem HTTPS. Od tych dwóch warunków zależy, czy Google w ogóle odczyta sygnał. Poprawny zapis wygląda tak:
<head>
  <link rel="canonical" href="https://przyklad.pl/kategoria/produkt" />
</head>
- Lokalizacja znacznika. Element Google akceptuje tylko w sekcji head, nigdy w . Sama sekcja head musi być poprawnym HTML-em, bo niedomknięty tag przed canonicalem potrafi go „wypchnąć” do body. Pliki PDF i inne dokumenty, które nie mogą zawierać tagów HTML (w przypadku treści tego typu brakuje sekcji head), kanonizuje się nagłówkiem HTTP (opis niżej).
- Jeden tag na podstronę. Każda strona powinna mieć tylko jeden kanoniczny adres URL. Dwie deklaracje rel="canonical" z różnymi adresami URL to dla Google sygnał sprzeczny. W takiej sytuacji wyszukiwarka zwykle ignoruje obie i wybiera wersję kanoniczną sama.
- Poprawne atrybuty. Znacznik składa się z atrybutu rel o wartości „canonical” i atrybutu href, w którym podajesz adres URL strony referencyjnej. Literówka w którymkolwiek z nich unieważnia deklarację.
- Adres bezwzględny. Href zawiera protokół, domenę i pełną ścieżkę, np. https://przyklad.pl/kategoria/produkt. Google technicznie obsługuje ścieżki względne typu /kategoria/produkt, ale ich nie zaleca: gdy przez pomyłkę zaindeksuje się wersja testowa serwisu, względny canonical wskaże na nią samą.
- Zgodność z wersją produkcyjną. Stosowanie bezwzględnych adresów nie wystarczy, jeśli adres w href nie odpowiada docelowej konfiguracji witryny: ta sama domena, ten sam protokół HTTPS, ta sama konwencja z „www” lub bez.
Błąd na poziomie tego jednego wiersza kodu potrafi zniweczyć efekt dobrze zoptymalizowanej treści, bo do indeksu trafia niewłaściwy wariant adresu.
Samo-referencyjne linki kanoniczne - dlaczego każda podstrona ich potrzebuje?
Każda indeksowalna podstrona powinna zawierać link kanoniczny wskazujący na samą siebie, czyli na adres strony, którą użytkownik właśnie ogląda, także wtedy, gdy nie ma znanych duplikatów. W takim self-referencing canonical wartość atrybutu href jest identyczna z adresem URL strony, na której znacznik się znajduje. Przykład dla wpisu blogowego:
Google wprost zaleca tę praktykę w swoich wytycznych.
Powód jest prozaiczny. Parametry UTM z kampanii, identyfikatory sesji czy parametry sortowania dopisywane automatycznie przez system tworzą nowe warianty adresu tej samej treści, często bez wiedzy administratora. Tag wskazujący na siebie rozstrzyga sprawę z góry i nie zostawia wątpliwości co do preferowanej wersji strony: niezależnie od tego, jaki parametr trafi do adresu, preferowany adres URL jest już zadeklarowany na każdej stronie.
Self-referencing canonical nie jest wymogiem absolutnym. Google przyznaje, że większość witryn poradzi sobie bez żadnej deklaracji, bo wyszukiwarka wybierze adres na podstawie innych sygnałów, np. mapy witryny i linkowania wewnętrznego. Naszym zdaniem na dużych serwisach z rozbudowaną strukturą URL nie warto na tym polegać. Koszt dodania tagu w szablonie jest bliski zeru, a ryzyko błędnego wyboru rośnie z każdym nowym parametrem.
Sprawdźmy potencjał Twojej strony
Podaj adres swojej strony i e-mail - odezwiemy się z konkretną analizą, bez zobowiązań.
Hierarchia sygnałów kanonizacji - jak Google interpretuje i waży wskazówki?
Google nie traktuje wszystkich wskazówek kanonizacji równorzędnie. Dokumentacja Search Central wymienia je w kolejności siły: przekierowania to silny sygnał, że cel przekierowania ma zostać wersją kanoniczną, tag rel="canonical" to również silny sygnał, a obecność w mapie witryny (sitemap.xml) to sygnał słaby. Metody się sumują, więc zgodne użycie dwóch lub trzech z nich zwiększa szansę, że Google wybierze zamierzony adres.
Adres wskazany w znaczniku canonical to tzw. kanoniczny adres URL zadeklarowany przez użytkownika (user-declared canonical). Google w większości przypadków go honoruje, ale nie zawsze. Jeśli przekierowania, linkowanie wewnętrzne albo mapa witryny wskazują inaczej, a algorytm uzna inny URL za bardziej reprezentatywny, powstaje URL kanoniczny wybrany przez Google, różny od deklaracji w kodzie strony. Dana strona zostaje wtedy potraktowana jako duplikat, a w wynikach pojawia się adres kanoniczny wskazany przez algorytm. Pomaga konsekwencja w linkowaniu na Twojej witrynie: linki wewnętrzne powinny prowadzić do adresu kanonicznego, nie do jego wariantów.
Mapa witryny nie zastępuje tagu canonical, tylko go potwierdza. Mapa witryny powinna zawierać wyłącznie kanoniczne adresy. Jeśli sitemap.xml zgłasza inny adres niż ten w rel="canonical", powstaje konflikt, a Google wprost odradza podawanie różnych kanonicznych adresów dla tej samej strony różnymi metodami. W takim sporze wygrywają silniejsze sygnały, a obecność w mapie strony niczego nie przesądza.
| Sygnał kanonizacji | Siła sygnału dla Google | Charakter | Może zostać zignorowany? |
|---|---|---|---|
| Przekierowanie 301 | Silny sygnał (najsilniejszy z trzech) | Techniczny, realizowany na poziomie serwera | Rzadko, zwykle przy łańcuchach lub błędach przekierowań |
| Tag rel="canonical" (adres zadeklarowany przez użytkownika) | Silny sygnał (wskazówka) | Deklaracja w kodzie HTML lub nagłówku HTTP | Tak, przy błędach lub sprzecznych sygnałach |
| Obecność URL w mapie witryny (sitemap.xml) | Słaby sygnał wspierający | Informacyjny, uzupełniający | Tak, łatwo nadpisywany przez inne sygnały |
Żaden pojedynczy sygnał nie gwarantuje, że Google wybierze zamierzony kanoniczny adres URL. Skuteczna kanonizacja wymaga zgodności tagu, przekierowań, mapy witryny i linków wewnętrznych.
Przekierowanie 301 a link kanoniczny - kiedy stosować poszczególne rozwiązania?
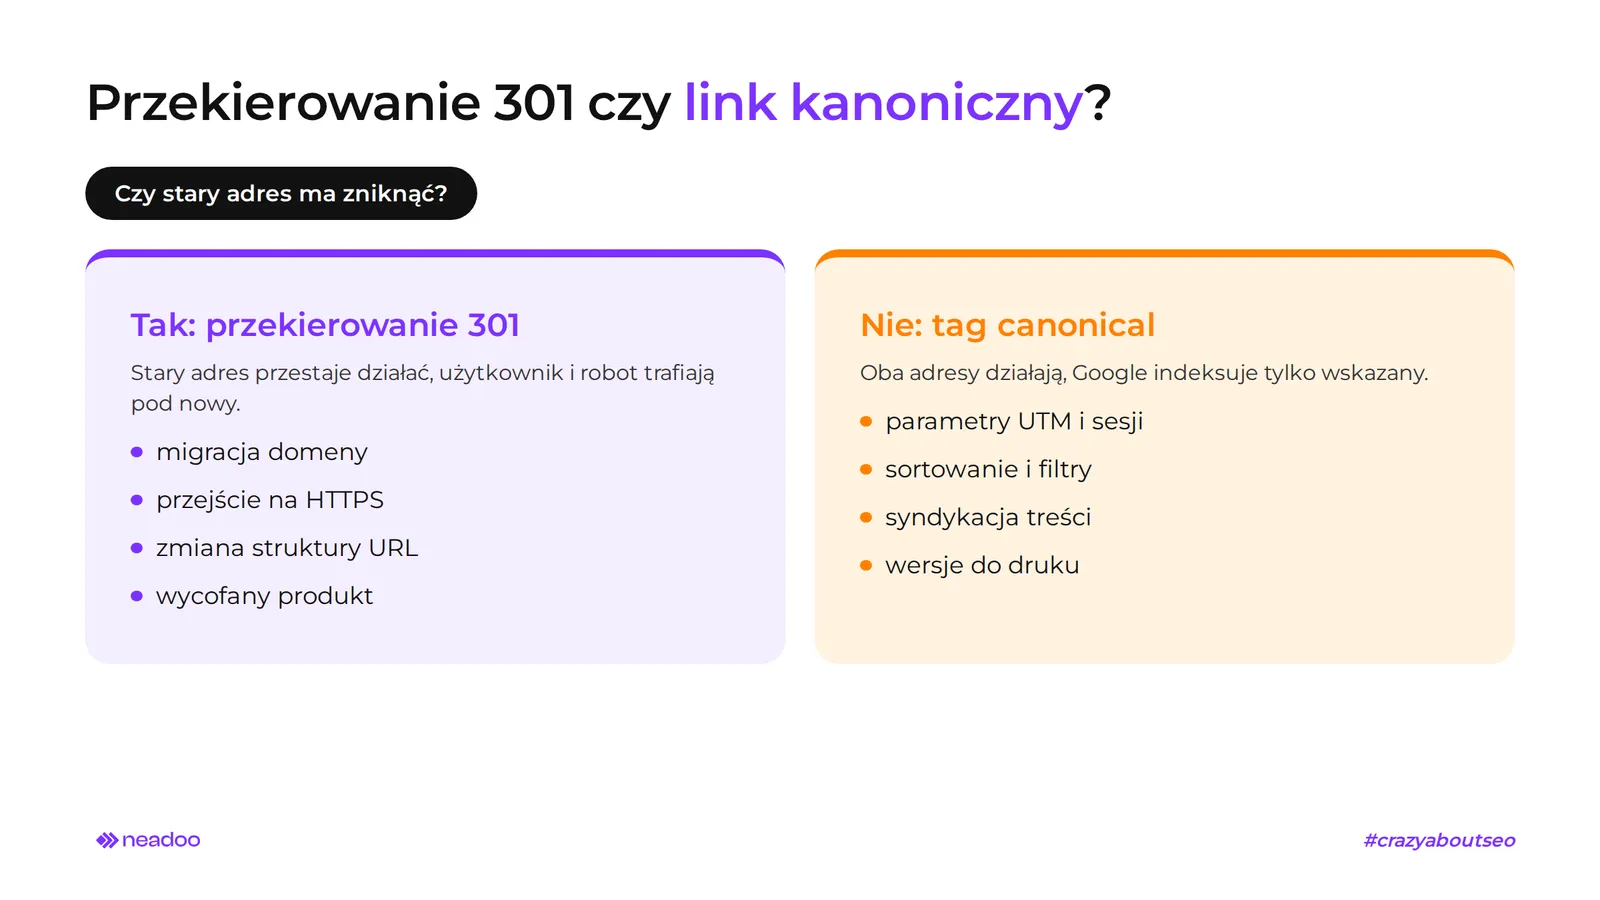
Wybór zależy od jednego pytania o przyszłość konkretnej strony: czy stary adres ma zniknąć, czy pozostać dostępny dla użytkowników, a Google ma tylko wiedzieć, którą wersję indeksować. Przekierowanie 301 przenosi ruch i sygnały na nowy adres i likwiduje stary jako punkt dostępu. Link kanoniczny niczego nie usuwa, deklaruje wyłącznie, który adres jest preferowany do indeksowania.
- Migracja lub trwałe usunięcie strony. Przekierowanie 301 stosuje się przy zmianie struktury URL, konsolidacji domen, przejściu na HTTPS albo zastąpieniu wycofanego produktu jego następcą. Stary adres przestaje być osobnym celem dla użytkownika i robota.
- Oba adresy muszą działać. Wersje z parametrami UTM, identyfikatorami sesji, sortowaniem czy filtrami w e-commerce oznacza się tagiem canonical. Użytkownik może wejść na każdą z nich, a Google indeksuje tylko wskazaną.
- Canonical między domenami (cross-domain canonicalization). Gdy ta sama treść funkcjonuje w dwóch domenach, np. przy syndykacji artykułu albo po przejęciu innej marki, tag rel="canonical" może wskazywać adres w innej domenie. Obie kopie zostają online, a wartość SEO trafia do źródła, choć identyczna treść jest dostępna pod różnymi adresami URL.
- Robots.txt. Canonical działa tylko wtedy, gdy robot może pobrać stronę z tym tagiem. Adres zablokowany w pliku robots.txt nie zostanie odczytany, więc jego deklaracja przepada. Google odradza też używanie tego mechanizmu jako narzędzia kanonizacji, bo zablokowany URL i tak może trafić do indeksu, tylko bez treści.
- Mapa witryny. Sitemap powinna zawierać wyłącznie kanoniczne adresy URL, bez wariantów przekierowanych i bez stron wskazujących inny URL jako canonical.
- Pliki bez HTML. PDF-y i inne dokumenty bez sekcji head kanonizuje się nagłówkiem HTTP Link, opisanym w osobnej sekcji.
Zasada praktyczna: 301 tam, gdzie stary adres ma odejść bezpowrotnie, canonical tam, gdzie oba adresy muszą zostać, a wyszukiwarka ma tylko wybrać, który pokazać.
Zastosowanie linków kanonicznych w e-commerce - filtry, sortowanie i nawigacja fasetowa
Zastosowanie linków kanonicznych w sklepach internetowych ogranicza indeksowanie tysięcy niemal identycznych stron, które generują filtry i sortowanie, i kierują sygnały na główną kategorię. Problem z powielaniem treści dotyczy każdej nawigacji fasetowej, w której warianty różnią się tylko parametrami URL (kolor, rozmiar, cena, kierunek sortowania), a treść pozostaje ta sama.
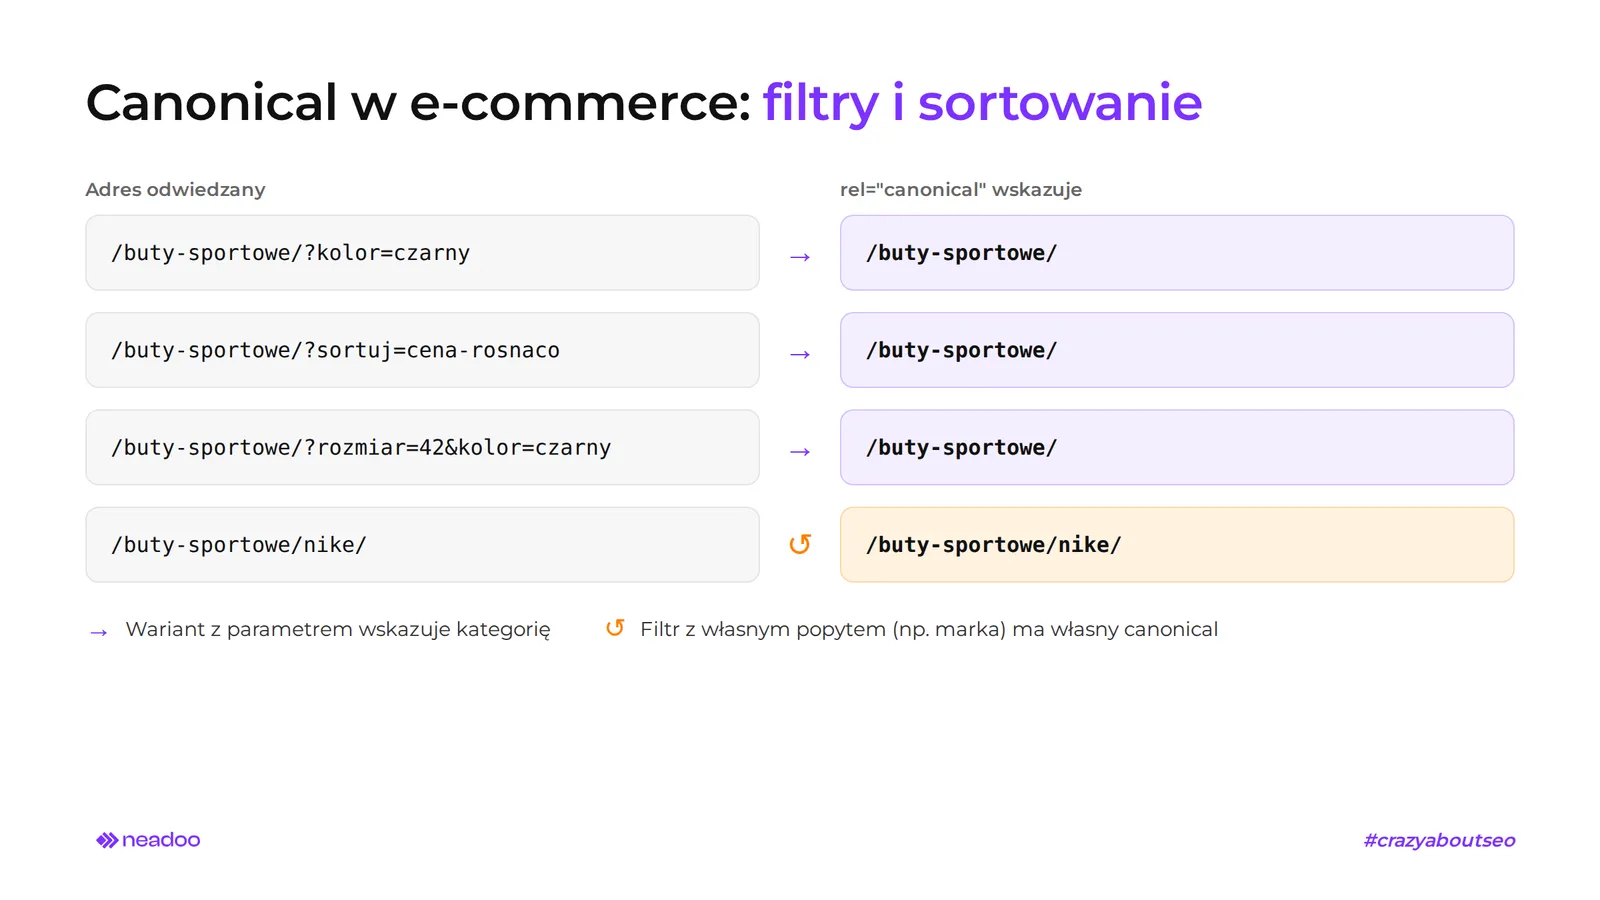
Kategoria „buty sportowe” łatwo tworzy warianty `?rozmiar=42`, `?kolor=czarny`, `?sortuj=cena-rosnaco` i ich złożenia. Dla robota każdy z nich wygląda jak osobna strona. Bez oznaczenia setki takich adresów trafiają do kolejki indeksowania, a sklep ma klasyczną duplikację treści (duplicate content).
Rozwiązaniem jest stosowanie linków kanonicznych na wszystkich wariantach z parametrami, tak by wskazywały adres kategorii bez filtrów i sortowania. Strona `/buty-sportowe/?kolor=czarny&sortuj=cena` zawiera w sekcji head:
Adres kanoniczny to więc /buty-sportowe/, choć użytkownik może swobodnie korzystać z wersji przefiltrowanej i zapisać ją w zakładkach.
Nie każdy filtr zasługuje na to samo traktowanie. Filtr marki w dużej kategorii często generuje własne zapytania z realnym wolumenem, np. „buty sportowe nike”. Takie kombinacje warto zostawić indeksowalne, z własnym adresem kanonicznym i unikalną treścią, bo strona ma wtedy szansę na pozycję dla odpowiednich zapytań w wynikach wyszukiwania. Decyzja wymaga analizy wolumenu wyszukiwań i struktury oferty, dlatego jest stałym elementem pozycjonowania sklepów internetowych. Przy tysiącach kombinacji sam canonical nie wystarczy: warto też ograniczyć linkowanie do bezwartościowych wariantów, żeby robot w ogóle ich nie odkrywał.
Wpływ renderowania JavaScript na tagi kanoniczne
Najbezpieczniej jest umieścić tag kanoniczny w statycznym kodzie HTML i nie zmieniać go skryptem. Tak brzmi zalecenie Google dla witryn renderowanych po stronie klienta. Jeśli canonicala nie da się dodać w kodzie źródłowym, Google dopuszcza wstawienie go wyłącznie przez JavaScript, ale wtedy statyczny HTML nie może zawierać żadnej innej wersji.
Kłopot wynika z dwuetapowego przetwarzania stron w React, Vue czy Angular. Googlebot najpierw pobiera surowy HTML, a wersję po wykonaniu JavaScriptu przetwarza później, w kolejce renderowania. Jeśli statyczny kod HTML wskazuje adres A, a skrypt podmienia canonical na adres B, Google dostaje dwie sprzeczne deklaracje i może wybrać którąkolwiek albo zignorować obie.
Najczęściej psuje to dynamiczne nadpisywanie atrybutu href zależnie od sesji, testów A/B czy personalizacji. To, co widzi przeglądarka, rozjeżdża się wtedy z tym, co robot odczytał w pierwszej fazie. Najpewniejsze rozwiązania to server-side rendering albo stały wpis canonical w szablonie serwerowym.
Na dużych serwisach JS-owych kolejka renderowania dodatkowo opóźnia moment, w którym Google widzi ostateczną wersję strony. Canonical dostępny od razu w surowym HTML eliminuje to ryzyko.
Kanonizacja plików nie-HTML za pomocą nagłówka HTTP Link
Pliki bez kodu HTML, takie jak PDF-y, kanonizuje się nagłówkiem HTTP Link wysyłanym przez serwer, bo nie mają sekcji head, w której mógłby stanąć tag rel="canonical". Mechanizm opisuje specyfikacja Web Linking, pierwotnie RFC 5988, od 2017 roku zastąpiona przez RFC 8288. Sam typ relacji „canonical” definiuje RFC 6596.
Google traktuje rel="canonical" w nagłówku Link jako równoważną metodę deklaracji. Działa dla plików PDF, dokumentów Word i innych zasobów bez znaczników HTML. Serwer dołącza do odpowiedzi nagłówek:
Link: <https://przyklad.pl/dokument.pdf>; rel="canonical"
Adres w nawiasach kątowych wskazuje wersję referencyjną, a Google stosuje tę metodę w wynikach wyszukiwania internetowego. Na stronach HTML nie łącz nagłówka z tagiem w kodzie: Google uznaje taki duet za podatny na błędy, bo łatwo o dwa różne adresy.
Metoda przydaje się, gdy jeden PDF jest dostępny pod różnymi adresami URL, np. na kilku subdomenach albo w starych lokalizacjach po migracji serwera plików. Nagłówek pozwala wskazać stronę kanoniczną, czyli jedną wersję referencyjną pliku, a pozostałe kopie mogą zostać online. Roboty wyszukiwarki traktują je wtedy jako warianty pozostałych adresów, nie jako osobne dokumenty.
Wdrożenie wymaga konfiguracji serwera (Apache, Nginx) lub CDN, bez edycji samego pliku. W repozytoriach dokumentacji technicznej czy katalogach z instrukcjami PDF regułę ustawia się zwykle globalnie dla całego katalogu.
Jak linki kanoniczne optymalizują budżet indeksowania (crawl budget)?
Wskazanie kanonicznych adresów pomaga Googlebotowi skupić się na adresach, które mają znaczenie. Google najregularniej skanuje kanoniczny URL, a jego duplikaty rzadziej. Znacznik obsługują też inne wyszukiwarki internetowe, m.in. Bing. Crawl budget, czyli liczba adresów, które Googlebot może i chce odwiedzić w danym czasie, zależy od wydajności serwera oraz od popytu na skanowanie: popularności adresów, ich aktualności i liczby wykrytych URL-i.
Uczciwe zastrzeżenie: canonical nie blokuje skanowania. Robot i tak odwiedza zduplikowane adresy, tylko rzadziej, bo musi odczytać deklarację. Tag porządkuje więc indeks i z czasem odciąża crawl, ale przy milionach kombinacji filtrów trzeba go połączyć z ograniczeniem linkowania do zbędnych wariantów.
Oszczędności widać głównie w przypadku dużych witryn: sklepach z tysiącami wariantów produktów i portalach z rozbudowanym archiwum. Typowe źródła duplikatów to parametry sesji, identyfikatory kampanii, wersje z „www” i bez oraz różna wielkość liter w ścieżce. Google traktuje /Buty i /buty jako dwa osobne adresy, dlatego stosuj małe litery w adresach URL i przekierowuj warianty z wielkimi literami na wersję właściwą.
Gdy robot marnuje mniej czasu na duplikaty, zmiany w witrynie szybciej trafiają do wyników wyszukiwania: nowe produkty, aktualizacje cen i świeże artykuły. W serwisach zależnych od aktualności treści to realna przewaga.
Najczęstsze błędy przy wdrażaniu rel="canonical" i jak ich unikać
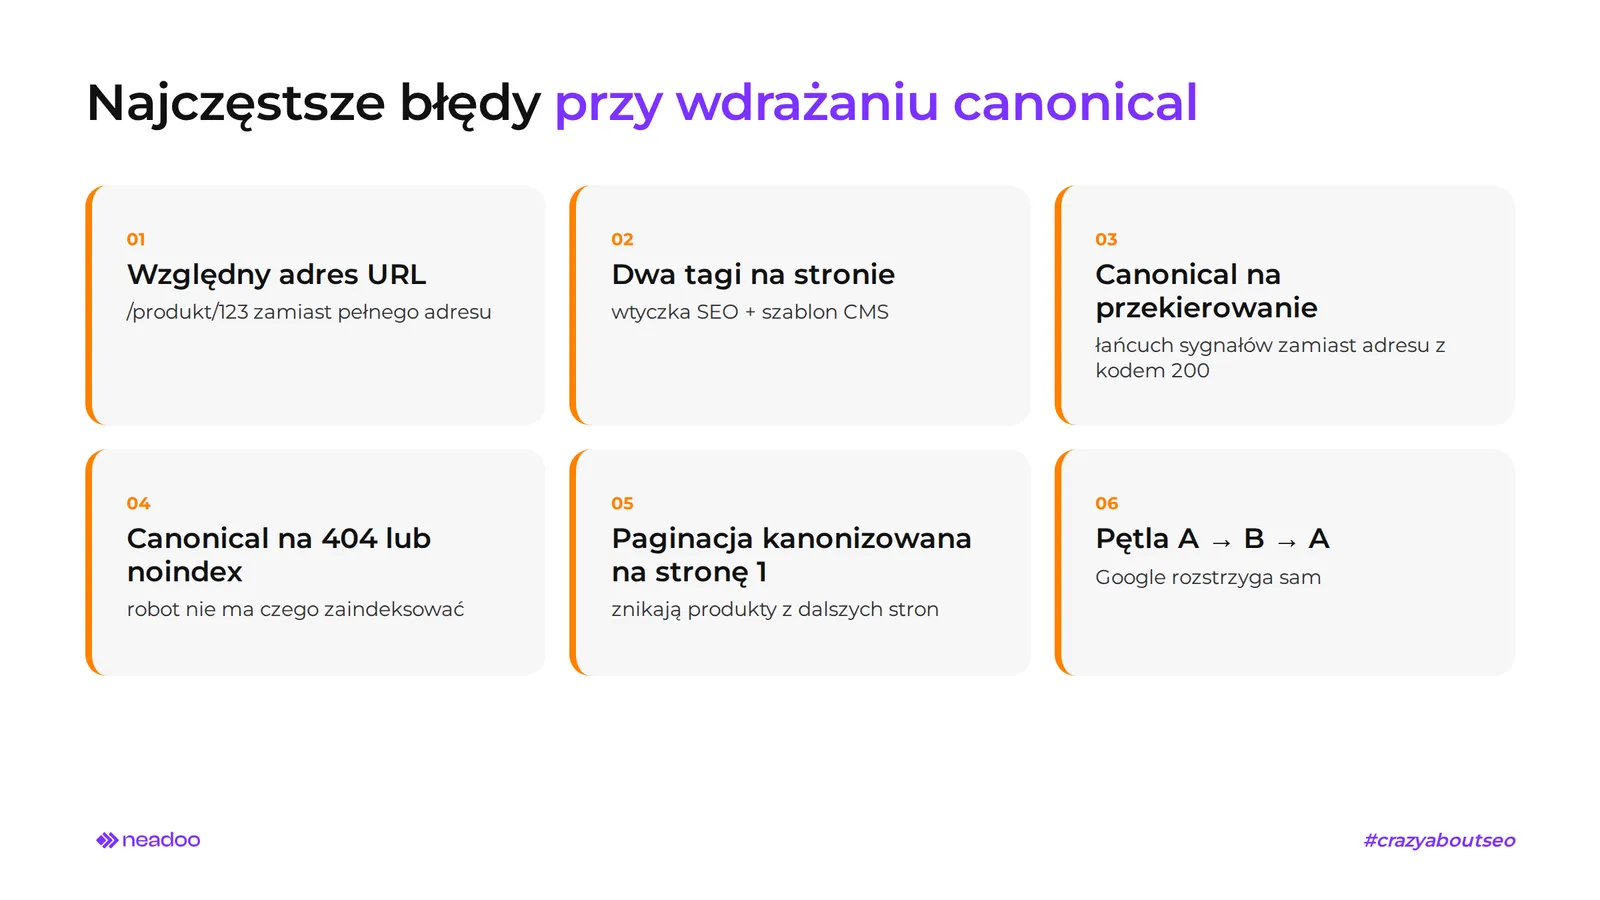
Typowe błędy przy wdrażaniu rel="canonical" to względne adresy zamiast bezwzględnych, kilka tagów w jednej sekcji head oraz błędne połączenie kanonizacji z paginacją i hreflang. We wszystkich tych przypadkach Google może zignorować deklarację i wybrać wersję kanoniczną sam, często niezgodnie z intencją właściciela witryny. Częstszy od błędnego tagu jest jednak zwykły brak tagów kanonicznych dla zduplikowanych stron. W przypadku stron generowanych automatycznie, np. wyników wyszukiwania wewnętrznego czy tagów bloga, to sytuacja powszechna, bo nikt nie sprawdza, czy system CMS w ogóle dodaje znacznik.
- Względny adres URL. Ścieżka /produkt/123 zamiast pełnego adresu szczególnie szkodzi przy migracjach domeny i wielu subdomenach.
- Dwa tagi canonical na jednej stronie. Najczęstsza przyczyna to wtyczka SEO, która dodaje własny znacznik obok tego z szablonu CMS.
- Canonical wskazujący stronę przekierowaną 301. Tworzy łańcuch sygnałów i wydłuża przetwarzanie adresu. Canonical powinien prowadzić prosto do docelowego adresu URL z kodem 200.
- Canonical wskazujący stronę z kodem 404 lub noindex. Robot dostaje sprzeczne instrukcje i nie ma czego zaindeksować. Adres kanoniczny musi być indeksowalny i zwracać kod 200.
- Canonical na inną domenę bez powodu. Przykład: szablon skopiowany z wersji testowej wskazuje adresy stagingu zamiast adresów w jednej domenie produkcyjnej. Google zwykle zignoruje taką deklarację, ale do czasu wykrycia błędu część stron może wypaść z indeksu.
Błędy w łączeniu z paginacją i tagami hreflang
Na stronach paginacji każda podstrona powinna mieć samo-referencyjny tag kanoniczny: strona 2, 3 czy 4 listy produktów wskazuje na samą siebie, nie na stronę 1. Kanonizowanie całej serii na pierwszą stronę to błąd, którego nie polecamy w żadnym wariancie, bo usuwa z indeksu produkty widoczne tylko na dalszych stronach.
Przy hreflang zasada jest analogiczna: każda wersja językowa ma własny, samo-referencyjny canonical, a hreflang informuje o odpowiednikach językowych, nie o ważności. Google zaleca, by kanoniczny adres URL prowadził do wersji w tym samym języku co strona z hreflang. Błąd wygląda tak: polska wersja ma hreflang="de" do wersji niemieckiej, a jej canonical wskazuje wersję angielską. Instrukcje są sprzeczne i Google zwykle indeksuje tylko jedną wersję językową.
Sprzeczne sygnały i pętle kanoniczne
Pętla kanoniczna powstaje, gdy strona A wskazuje jako stronę kanoniczną stronę B, a B wskazuje z powrotem A. Google nie ma podstaw do wyboru i rozstrzyga sam, niekoniecznie zgodnie z intencją.
Sprzeczność pojawia się też między mechanizmami: link kanoniczny wskazuje jeden adres, a sitemap.xml zgłasza inny, albo link kanoniczny wskazuje wersję A, podczas gdy nagłówek X-Robots-Tag ustawia dla niej noindex. Google odradza używanie noindex do sterowania wyborem kanonicznego adresu w obrębie jednej domeny, bo blokuje to stronę w wyszukiwarce całkowicie.
Dlatego w audytach SEO kanonizację sprawdzamy na samym początku porządkowania architektury serwisu. Bez spójnych sygnałów dalsza optymalizacja treści i linków nie daje pełnego efektu.
Jak wdrożyć i sprawdzić linki kanoniczne w CMS oraz narzędziach SEO?
Linki kanoniczne w popularnych CMS-ach konfiguruje się w panelu lub wtyczce SEO, a ich poprawność sprawdza się w Google Search Console i crawlerach, takich jak Screaming Frog. Ręczna edycja sekcji head jest możliwa, ale większość właścicieli stron internetowych korzysta z mechanizmów platformy.
Konfiguracja w systemach WordPress, PrestaShop i Shopify
W popularnych CMS-ach ustawienie tagu kanonicznego zwykle nie wymaga edycji szablonu ani zmian w konfiguracji witryny.
| System CMS | Sposób konfiguracji canonical | Uwagi |
|---|---|---|
| WordPress | Wtyczki Yoast SEO lub All in One SEO, pole „canonical URL” w ustawieniach zaawansowanych wpisu lub strony | Wtyczka generuje tag automatycznie, z możliwością ręcznego nadpisania |
| PrestaShop | Ustawienia SEO i URL w panelu (m.in. przekierowanie do kanonicznego adresu), tag w motywie lub module SEO | Działanie zależy od wersji i motywu; wymaga kontroli przy kombinacjach filtrów |
| Shopify | Canonical generowany automatycznie w pliku theme.liquid (zmienna canonical_url), edycja w kodzie motywu lub przez aplikacje SEO | Ograniczona możliwość zmian bez znajomości Liquid |
| System z ręcznym kodem HTML | Tag rel="canonical" dodawany bezpośrednio w sekcji head szablonu | Wymaga dyscypliny przy każdej zmianie struktury URL |
Yoast SEO domyślnie ustawia samo-referencyjny canonical dla każdego wpisu, a pole edycji pozwala go nadpisać, np. przy treści celowo powielonej z innej podstrony. Wystarczy otworzyć na swojej stronie wpis, który chcesz oznaczyć, i wpisać w polu kanoniczny adres URL strony źródłowej. All in One SEO działa podobnie i dodaje reguły dla taksonomii oraz archiwów. W sklepach na PrestaShop najwięcej uwagi wymagają strony filtrów i sortowania, które muszą konsekwentnie wskazywać wersję bez parametrów.
Weryfikacja w Google Search Console i Screaming Frog
Najszybszy test, czy linki kanoniczne na Twojej witrynie działają, nie wymaga żadnego narzędzia. W Google Chrome kliknij prawym przyciskiem myszy na stronie, wybierz „Wyświetl źródło strony” i wyszukaj frazę rel="canonical". Zobaczysz, jaki adres wskazuje tag i czy na stronie znajduje się tylko jeden taki znacznik.
Google Search Console pokazuje z kolei, który adres Google faktycznie uznaje za kanoniczny. Narzędzie do sprawdzania adresów URL zestawia kanoniczny adres URL zadeklarowany przez użytkownika z kanonicznym URL wybranym przez Google. Raport „Indeksowanie stron” grupuje adresy ze statusami duplikatów, np. gdy Google wybrał inną stronę kanoniczną niż wskazana. Rozbieżność rzadko oznacza błąd wyszukiwarki. Zwykle oznacza sprzeczne dane w sitemapie, przekierowaniach lub linkowaniu wewnętrznym.
Screaming Frog sprawdza tagi canonical w skali całej witryny internetowej. Crawler porównuje adres strony skanowanej z wartością href w jej tagu kanonicznym i filtruje m.in. strony bez canonicala, z kilkoma tagami, z adresem względnym albo takie, w których URL kanoniczny sam wskazuje dalej inny adres. Crawl środowiska testowego pozwala wyłapać te błędy przed publikacją zmian.
Ahrefs w module Site Audit wykrywa duplikację treści, grupuje zduplikowane strony i sprawdza, czy każdy ma poprawny tag canonical. Te trzy narzędzia się uzupełniają: Search Console pokazuje decyzję Google, Screaming Frog audytuje kod, a Ahrefs daje obraz duplikacji w całej domenie.
FAQ
Czy Google zawsze uwzględnia tag rel="canonical"?
Nie. Link kanoniczny to silna wskazówka, nie dyrektywa. Google może ją pominąć, gdy wskazana strona ma błędy, gdy przeczą jej inne sygnały (sitemap, przekierowania, linkowanie wewnętrzne) albo gdy inny adres uzna za bardziej reprezentatywny.
Czym różni się link kanoniczny od przekierowania 301?
Link kanoniczny wskazuje robotom preferowany adres URL, ale duplikat nadal działa i użytkownik może go odwiedzić. Przekierowanie 301 trwale przenosi użytkowników i roboty na nowy adres, a stary przestaje być dostępny.
Źródła
- Google Search Central, „What is URL canonicalization”: https://developers.google.com/search/docs/crawling-indexing/canonicalization
- Google Search Central, „How to specify a canonical URL with rel="canonical" and other methods”: https://developers.google.com/search/docs/crawling-indexing/consolidate-duplicate-urls
- Google Search Central, „Understand the JavaScript SEO basics”: https://developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics
- RFC 6596, The Canonical Link Relation: https://www.rfc-editor.org/rfc/rfc6596
- RFC 8288, Web Linking (zastępuje RFC 5988): https://www.rfc-editor.org/rfc/rfc8288