
Paginacja stron: definicja, wpływ na SEO i dobre praktyki wdrożenia
Prawidłowo wdrożona paginacja skraca czas ładowania witryny, optymalizuje strukturę DOM i ułatwia robotom indeksowanie głębokich podstron. Źle skonfigurowana tworzy duplikaty, rozprasza sygnały rankingowe i ukrywa część oferty przed indeksem.
Ten artykuł skupia się na znaczeniu cyfrowym paginacji: wyjaśniamy, co to jest paginacja, jak wpływa na SEO i UX oraz jak wdrożyć ją w sklepie internetowym, na blogu i w archiwum treści.
Czym jest paginacja i dlaczego serwisy dzielą treści
Paginacja stron (stronicowanie) to technika dzielenia dużych zbiorów danych, takich jak listy produktów, wpisy blogowe, wyniki wyszukiwania czy komentarze, na mniejsze, powiązane ze sobą porcje zamiast wyświetlania wszystkiego na jednej stronie. Termin pochodzi od łacińskiego słowa „pagina” i pierwotnie oznacza numerowanie stron publikacji, czyli paginację w książce, czasopiśmie lub katalogu (obok foliacji, która numeruje całe karty).
Serwisy dzielą treści na podstrony, aby skrócić czas ładowania, ułatwić użytkownikowi poruszanie się po dużym zbiorze i umożliwić robotom wyszukiwarek dotarcie do głębiej położonych adresów. Technika ta ma jednak także starsze, drukarskie znaczenie.
Paginacja w internecie a tradycyjne dokumenty i druk
W druku znaczenie paginacji jest węższe. W bibliografii i edytorstwie paginacja oznacza numerowanie pojedynczych stron, czym różni się od foliacji, czyli numerowania całych kart. Przy foliacji numer stoi tylko na karcie, a jej dwie strony rozróżnia się jako recto i verso (przód i tył).
Paginacja obejmuje wszystkie zapisane strony publikacji, także nieliczbowane, oznaczane skrótem „nlb.”. Wyróżnia się dwa układy:
- Paginacja ciągła – jedna numeracja prowadzona nieprzerwanie przez całe dzieło lub fizyczny tom.
- Paginacja wielokrotna – każda część tomu, np. kolejne dzieło lub numer czasopisma, ma własną numerację od początku.
Wpływ podziału treści na szybkość ładowania i strukturę DOM
Paginacja skraca czas ładowania i odświeżania witryny, ponieważ przeglądarka wczytuje naraz tylko ograniczoną część danych. Nie jest to jednak automatyczna gwarancja szybszego działania: efekt zależy od implementacji, zapytań serwerowych i rozmiaru odpowiedzi. Zapytanie z LIMIT i przesunięciem nadal może być wolne na dużej bazie bez właściwych indeksów.
Druga korzyść dotyczy struktury DOM. Strona z kilkuset kartami produktów lub komentarzy tworzy tysiące węzłów, co zwiększa zużycie pamięci, wydłuża renderowanie i spowalnia skrypty operujące na drzewie dokumentu. Kilkadziesiąt elementów na podstronę utrzymuje DOM mniejszy i łatwiejszy w obsłudze, szczególnie na słabszych telefonach.
Podział ma też skutek dla widoczności. Każda podstrona to odrębny adres w wynikach wyszukiwania i osobny dokument do przeczytania przez robota, co ułatwia dotarcie do głębiej położonych pozycji. W kontekście pozycjonowania sklepów oznacza to, że sposób podziału katalogu decyduje o tym, które produkty są w ogóle osiągalne przez linki.
Klasyczna paginacja, infinite scroll czy przycisk załaduj więcej
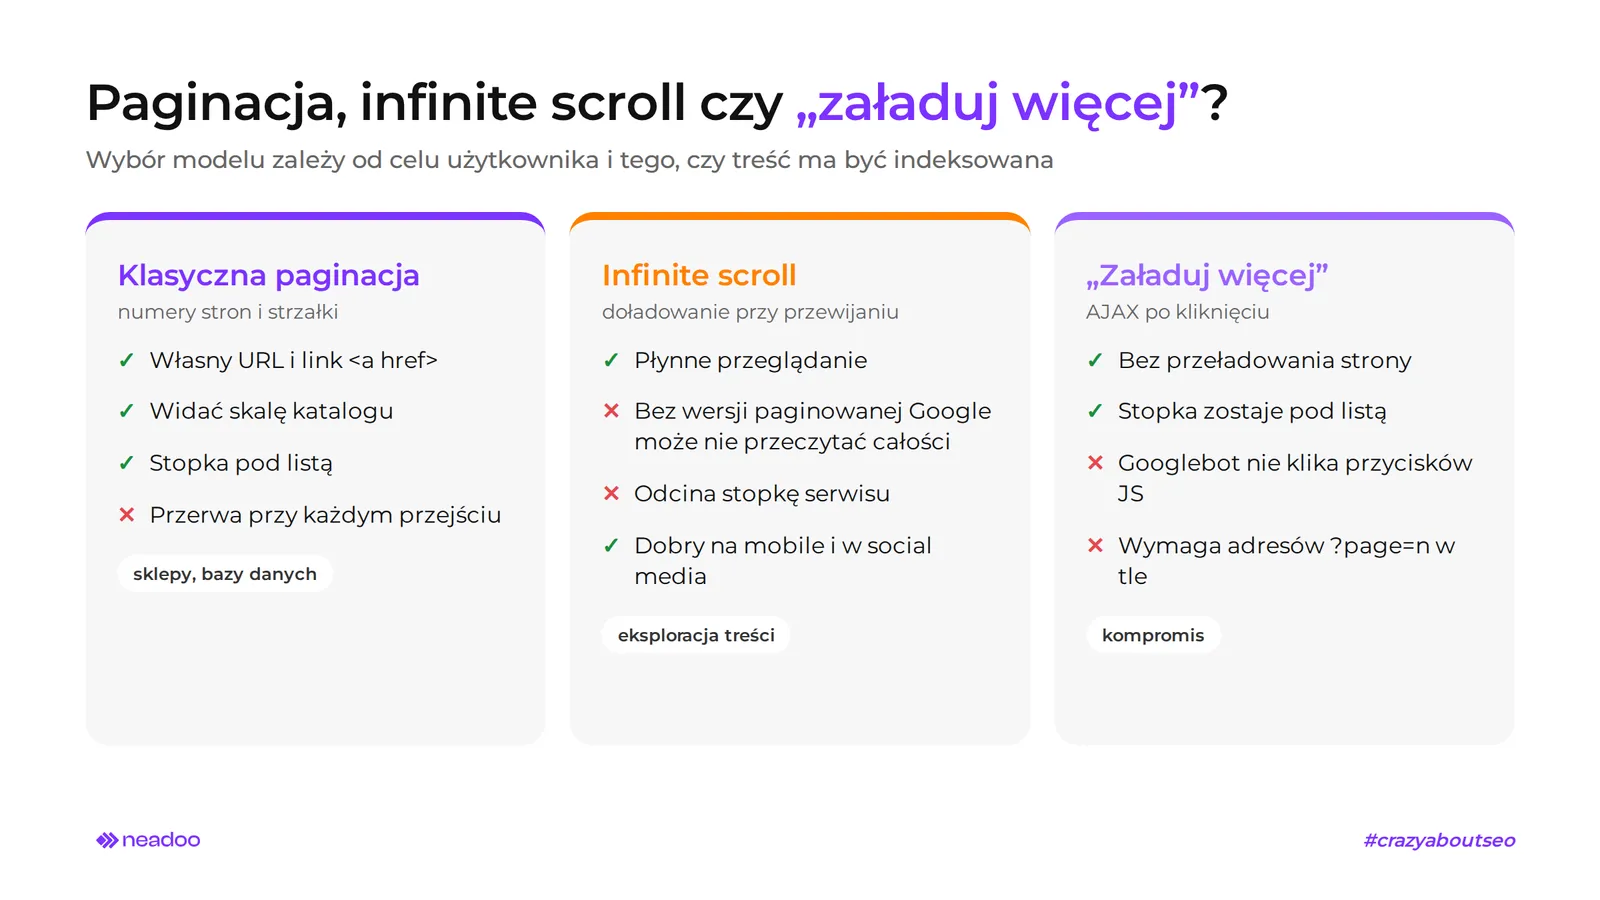
Trzy podstawowe modele przeglądania dużych list to klasyczna paginacja numeryczna, infinite scroll i przycisk „załaduj więcej”. Który z nich wybrać, zależy od celu użytkownika oraz od tego, czy treść ma być indeksowana przez roboty wyszukiwarek.
Wady i zalety popularnych modeli przeglądania
Klasyczna paginacja najlepiej sprawdza się w sklepach i bazach danych zorientowanych na cel, a infinite scroll sprzyja eksploracji, ale wymaga zaawansowanej architektury dla wyszukiwarek. Przycisk „załaduj więcej” (load more) leży pośrodku.
- Klasyczna paginacja numeryczna ze strzałkami. Każda porcja ma własny URL i zwykły link
<a href>, więc paginator jest w pełni crawlowalny. Użytkownik widzi skalę katalogu i może wrócić do konkretnej strony. Wadą jest przerwa w przeglądaniu przy każdym przejściu. - Infinite scroll. Treść doładowuje się automatycznie podczas przewijania w dół, co jest popularne w mediach społecznościowych i na urządzeniach mobilnych. Bez odpowiedniej architektury Google może nie przeczytać całości, dlatego zalecana jest dostępna wersja paginowana.
- Przycisk „załaduj więcej”. Kolejne elementy doczytują się przez AJAX po kliknięciu, bez przeładowania strony. Googlebot nie klika przycisków sterowanych wyłącznie JavaScriptem, więc samo ładowanie po kliknięciu nie daje indeksowalności.
Infinite scroll odcina użytkownika od stopki serwisu (kontakt, regulamin, koszty wysyłki), bo każde przewinięcie w dół doczytuje kolejne pozycje. Klasyczna paginacja i przycisk „załaduj więcej” zostawiają stopkę pod listą, dlatego w sklepach, gdzie użytkownik przed zakupem szuka warunków dostawy, są bezpieczniejszym wyborem. Jeśli zostajesz przy infinite scroll, przenieś kluczowe linki ze stopki do nagłówka lub przyklejonego paska.
Przy dużych zbiorach wybór modelu wpływa też na zaplecze: klasyczne numery stron zwykle opierają się na offset-based pagination, a doczytywanie ciągłe często na cursor-based pagination, która nie zwalnia na głębokich stronach. Offset zmusza bazę do pominięcia wszystkich wcześniejszych rekordów, więc obciążenie rośnie wraz z numerem strony. Cursor pobiera kolejną porcję od ostatnio zwróconego rekordu, dzięki czemu koszt zapytania jest podobny na każdej głębokości. Cursor nie daje jednak stabilnego adresu z numerem strony, dlatego dla treści, które mają być indeksowane, zachowaj osobne adresy ?page=n z linkami HTML. Zbyt duża liczba stron, filtrów i wariantów sortowania zużywa crawl budget i obciąża bazę zapytaniami, więc ogranicz je do tego, co ma realną wartość dla indeksu.
Hybrydowe wczytywanie treści z użyciem History API
Elementy paginacji muszą bazować na standardowych linkach <a href>, ponieważ Googlebot nie wykonuje zdarzeń JavaScript powiązanych z kliknięciem. Wdrożenie History API w infinite scroll pozwala dynamicznie aktualizować adres URL w przeglądarce, co umożliwia odświeżanie, udostępnianie i ponowne otwieranie konkretnej partii danych.
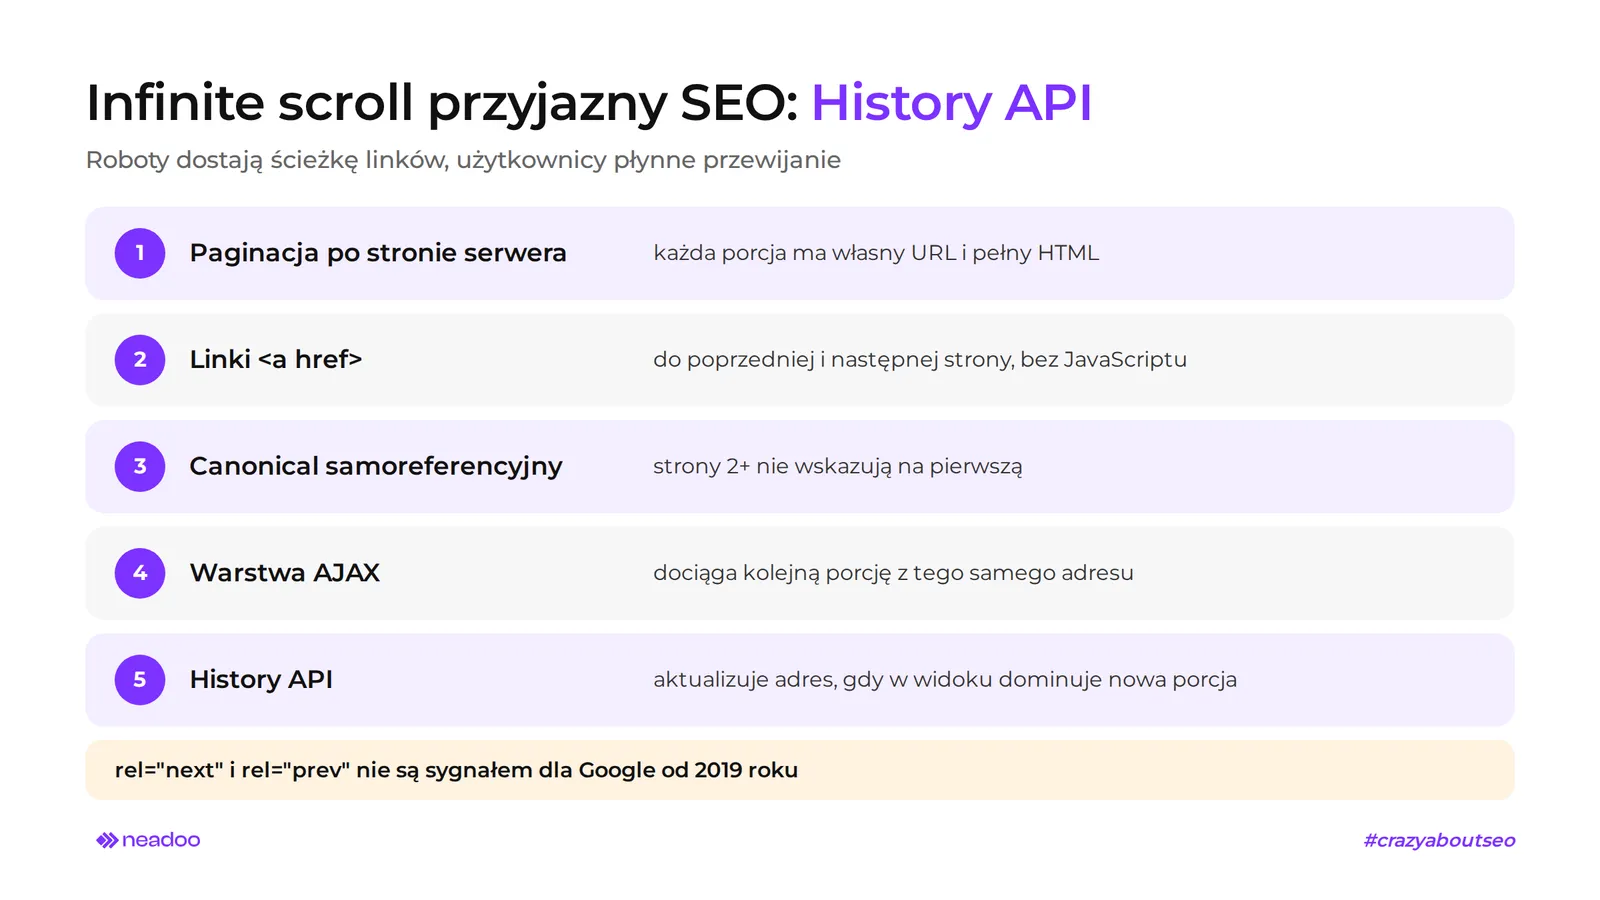
Jak połączyć przewijanie z wymogami wyszukiwarek – krok po kroku:
- Zbuduj paginację stron po stronie serwera: każda porcja ma unikalny adres URL z numerem strony i zwraca pełny HTML.
- Dodaj sekwencyjne linki
<a href>do poprzedniej i następnej strony, widoczne bez JavaScriptu. - Nadaj każdej indeksowalnej stronie samoodwołujący link kanoniczny; nie kanonikalizuj stron 2+ do pierwszej.
- Nałóż warstwę AJAX, która przechwytuje kliknięcie lub przewinięcie i dociąga następną porcję z tego samego adresu.
- Gdy w oknie widoku dominuje nowa porcja, zaktualizuj adres przez History API.
Znaczniki rel="next" i rel="prev" nie są już sygnałem indeksowania w Google, więc nie zastępują kroków 2 i 3. Taka konstrukcja daje robotom ścieżkę linków, a użytkownikom płynne przewijanie, bez gwarancji konkretnego wyniku w rankingu.
Techniczna optymalizacja paginacji pod kątem robotów Google
Paginacja sprzyjająca SEO opiera się na czterech elementach: unikalnych adresach (parametr lub ścieżka), własnych linkach kanonicznych, statusie index oraz zwykłych linkach HTML. Każda podstrona serii potrzebuje bezpośrednio dostępnego adresu, np. ?page=2 lub /strona/2/. Google traktuje je jako oddzielne strony w sekwencji, a dobrze skonfigurowana paginacja ułatwia robotom dotarcie do głębiej położonych podstron.
Kanonikalizacja i indeksacja
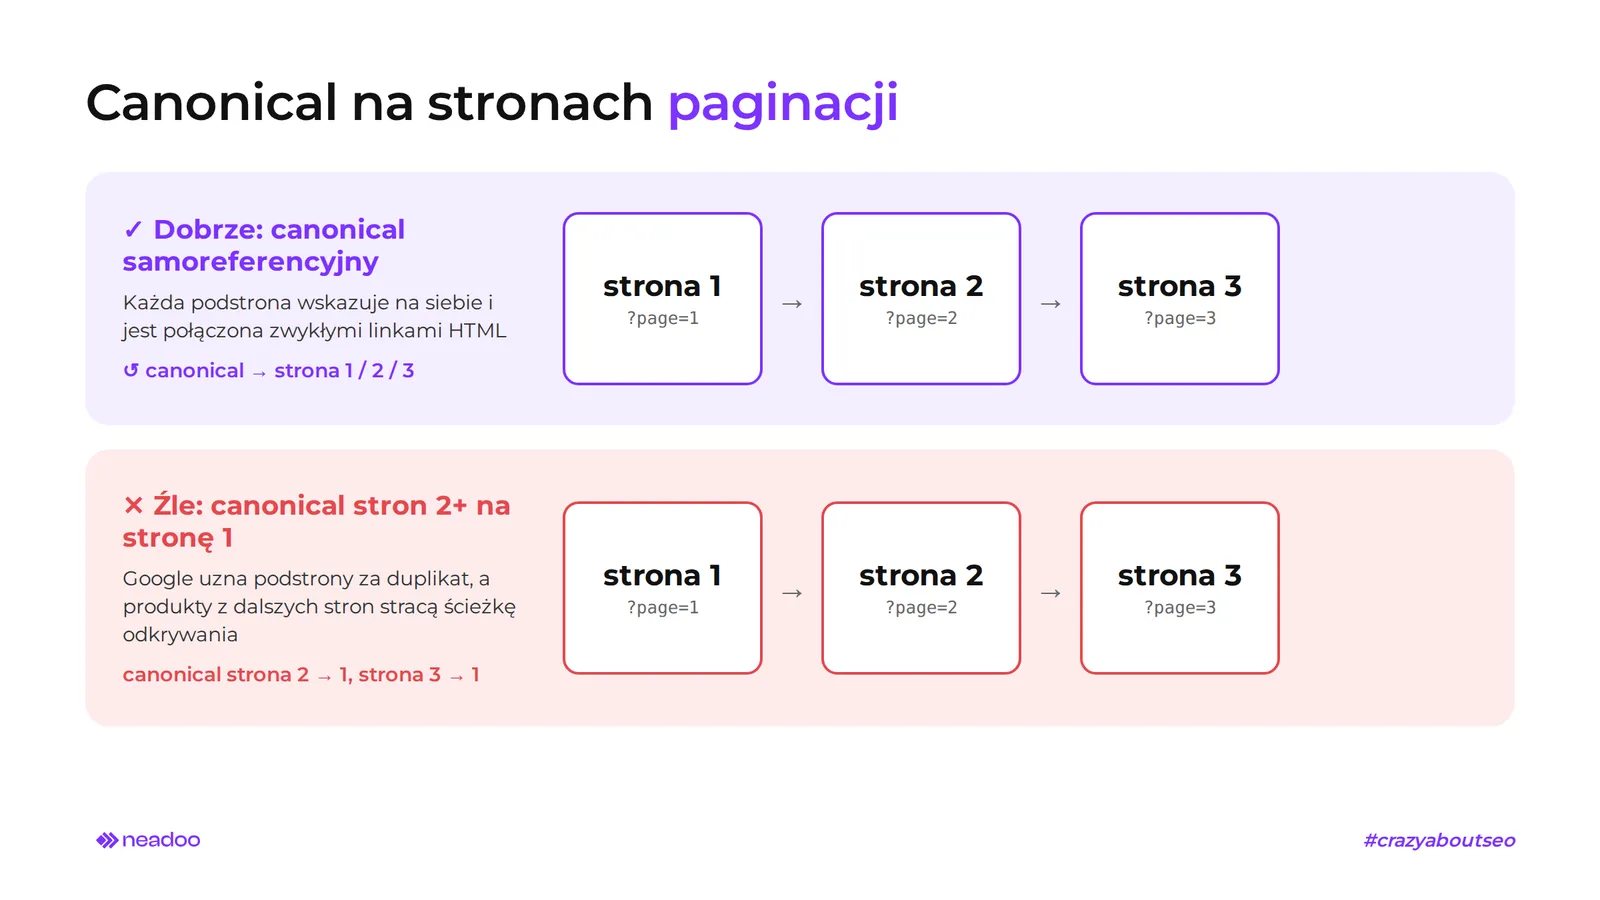
Paginacja wymaga zastosowania samoreferencyjnych tagów rel="canonical" na każdej podstronie serii zamiast kanonikalizacji do strony pierwszej. Kanonikalizacja stron 2+ do pierwszej skłania Google do uznania tych podstron za duplikat strony pierwszej, a produkty dostępne tylko z nich tracą ścieżkę odkrywania. Google zrezygnował z wykorzystywania atrybutów rel="next" i rel="prev": ogłosił to w marcu 2019 roku, dodając, że nie korzystał z nich już od lat. Nadal odczytuje je m.in. Bing, który używa ich do odkrywania stron i rozumienia struktury serwisu.
Pozostałe zasady:
- Jeśli /kategoria?page=1 duplikuje /kategoria, ustaw stałe przekierowanie 301 na adres główny.
- Dodawaj do tytułu i meta opisu kolejnych podstron wyróżnik, np. „– strona 2”.
- Rozbudowany tekst SEO i opis kategorii wyświetlaj tylko na pierwszej stronie serii.
- Podstron z wartościowymi linkami do produktów nie blokuj tagiem noindex ani w robots.txt, łącz je zwykłymi linkami HTML i umieść istotne z nich w sitemap.xml.
- Warianty sortowania i parametry filtrów bez wartości dla wyszukiwarki wyłącz z indeksu tagiem noindex. Jeśli zależy ci przede wszystkim na oszczędzaniu crawl budgetu, zablokuj je w robots.txt, ale nie łącz obu metod na tym samym adresie: zablokowanej strony Google nie pobierze, więc nie zobaczy na niej tagu noindex.
- Wybierz jeden format adresu: parametr (?page=2) i ścieżka (/strona/2/) są dla Google równoważne, ale w całym serwisie stosuj konsekwentnie jeden wzorzec.
- Nie opieraj paginacji na fragmentach URL: adresy z # (np. #page=2) są przez Google ignorowane.
- Generuj parametry w stałej kolejności. Przy łączeniu z filtrami i sortowaniem ?page=2&sort=cena i ?sort=cena&page=2 to dwa różne adresy z tą samą treścią.
Weryfikacja
Narzędzie do sprawdzania adresów URL w Google Search Console pokazuje wyrenderowany HTML, odnalezione linki wewnętrzne oraz kanoniczny adres zadeklarowany i wybrany przez Google. Screaming Frog SEO Spider audytuje kody HTTP, poprawność canonical i przerwy w linkowaniu paginacji.
Lista kontrolna
- [ ] Każda podstrona ma unikalny, dostępny adres URL.
- [ ] Każda podstrona ma samoreferencyjny rel="canonical".
- [ ] /kategoria?page=1 przekierowuje stałym 301 na /kategoria.
- [ ] Strony serii są połączone zwykłymi linkami HTML.
- [ ] Podstrony z wartościowymi linkami nie mają noindex ani blokady w robots.txt.
- [ ] Sortowanie i filtry są wykluczone z indeksacji lub skanowania (noindex albo blokada w robots.txt, nie obie metody naraz).
- [ ] W całym serwisie obowiązuje jeden format adresu, a paginacja nie opiera się na fragmentach #.
- [ ] Parametry w adresach (page, sort, filtry) występują w stałej kolejności.
- [ ] Tytuły i meta opisy mają unikalny wyróżnik.
- [ ] Tekst SEO jest tylko na pierwszej stronie serii.
- [ ] Istotne strony numerowane są w sitemap.xml.
- [ ] Canonical, kody HTTP i linkowanie sprawdzono w Google Search Console i Screaming Frog.
Sprawdźmy potencjał Twojej strony
Podaj adres swojej strony i e-mail - odezwiemy się z konkretną analizą, bez zobowiązań.
Projektowanie paginatora w sklepie internetowym pod kątem użyteczności
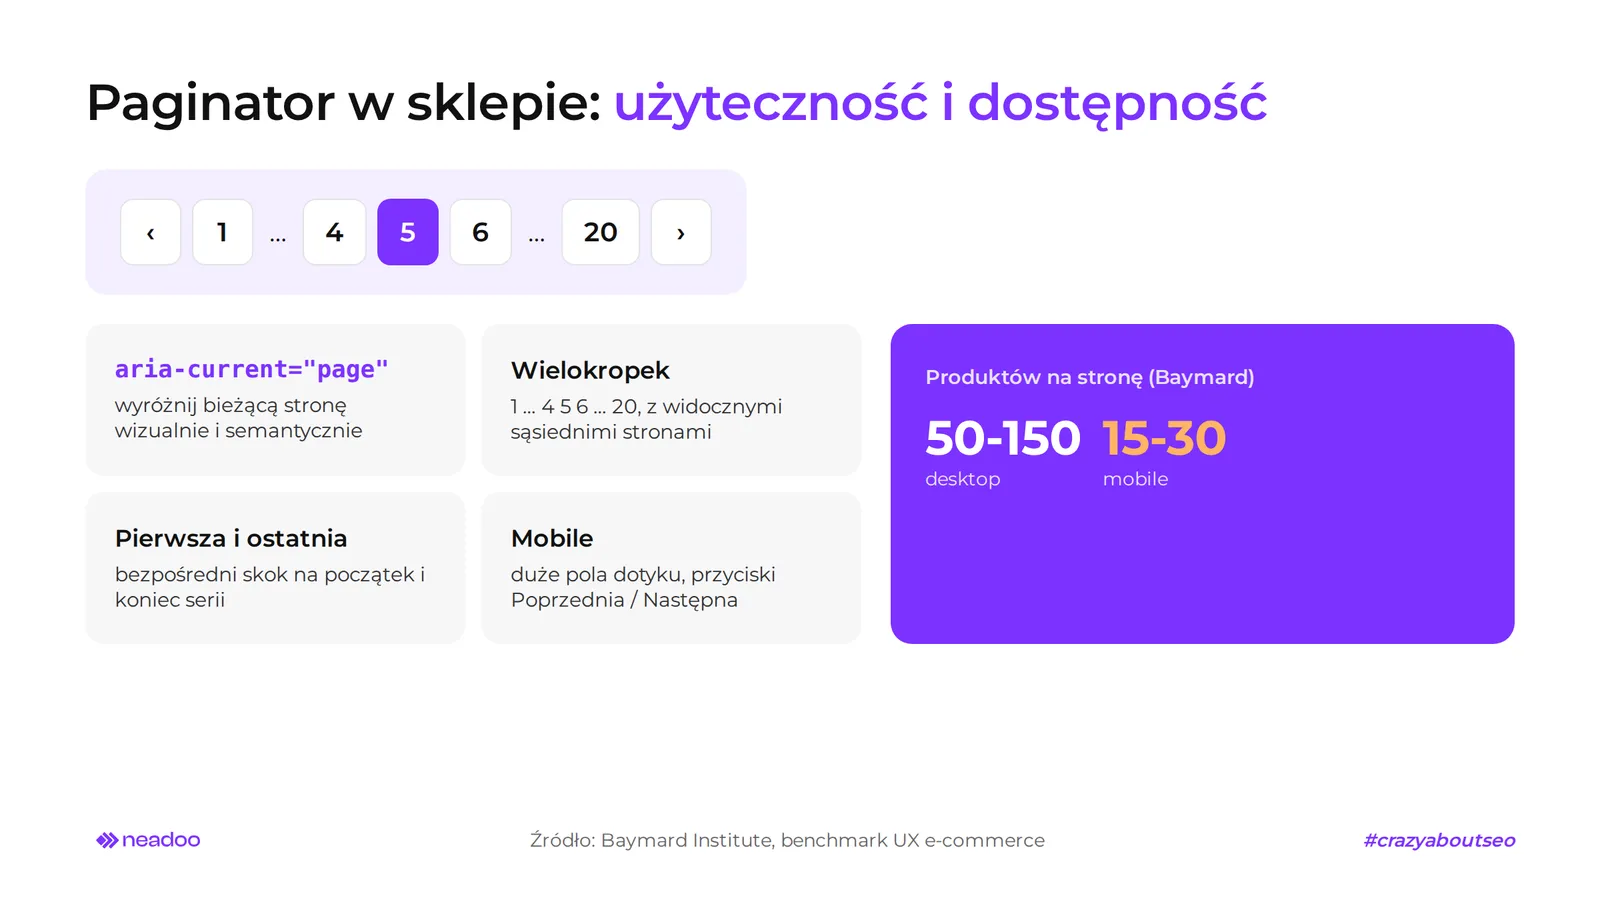
Użyteczny paginator pokazuje użytkownikowi, gdzie jest w katalogu, spełnia wymogi dostępności cyfrowej i wyświetla tyle produktów, ile pozwala wygodnie przeskanować wzrokiem dany asortyment.
Dostępność cyfrowa komponentu nawigacyjnego
Paginator wyróżnia bieżącą stronę wizualnie (kontrast, pogrubienie, tło) oraz semantycznie, atrybutem aria-current="page" ze specyfikacji WAI-ARIA. Czytnik ekranu zapowie wtedy bieżący numer, a nie tylko „link, 3”. Sam kolor nie wystarcza osobom z zaburzeniami widzenia barw.
Dodatkowe zasady projektowe:
- Pominięcia. Przy długiej serii użyj wielokropka nawigacyjnego (np. 1 … 4 5 6 … 20), ale zawsze zostaw widoczne linki do sąsiednich stron.
- Skoki. Zapewnij bezpośrednie przejście do pierwszej i ostatniej strony serii.
- Mobile. Wdróż responsywny komponent z dużymi polami dotyku; na wąskim ekranie ogranicz liczbę numerów na rzecz przycisków „Poprzednia” i „Następna”.
- Kod. Każdy element to zwykły link HTML, co służy też robotom.
Liczba pozycji w widoku produktów wizualnych i technicznych
Według benchmarku UX Baymard Institute z 2020 roku 52% sklepów w wersji desktopowej wyświetla domyślnie za mało albo za dużo produktów na stronie listy. Chodzi o równowagę między czasem ładowania a łatwością skanowania i porównywania ofert. Zbyt długa strona wydłuża ładowanie i marnuje crawl budget, a zbyt krótka zmusza do ciągłego klikania.
| Kryterium | Visually Driven Products | Spec-Driven Products |
|---|---|---|
| Przykłady | odzież, dekoracje, meble | elektronika, narzędzia, części |
| Sposób wyboru | wzrokowy, po zdjęciu | czytanie i porównywanie parametrów |
| Liczba pozycji na stronę | większa | mniejsza |
| Skanowanie | szybki przegląd miniatur | analiza parametrów w kartach |
| Ryzyko przy nadmiarze | wolne ładowanie zdjęć | utrata czytelności porównań |
Baymard podaje orientacyjne widełki: 50–150 produktów na stronę w e-commerce na desktopie i 15–30 na urządzeniach mobilnych.
Selektor liczby elementów na stronę pozwala użytkownikowi zmienić domyślną wartość, ale ustawienie bazowe powinno wynikać z typu asortymentu. W 2024 roku Baymard zmienił swoją rekomendację z „unikaj wyboru liczby elementów na stronie” na „jest akceptowalny przy paginacji, choć pewnie rzadko używany”.
FAQ
Czy podstrony paginacji powinny mieć tag noindex?
Zwykle nie. Jeśli podstrony zawierają linki do produktów lub wpisów, noindex może z czasem ograniczyć ich skanowanie, bo Google rzadziej odwiedza strony wyłączone z indeksu. Popularne ustawienie „noindex, follow” nie rozwiązuje problemu. Google potwierdziło, że strona długo wyłączona z indeksu jest z czasem traktowana jak „noindex, nofollow”, więc linki do produktów na dalszych podstronach przestają przekazywać link equity i mogą przestać być śledzone. Noindex stosuj raczej do wariantów sortowania i filtrów, a nie do podstawowej serii numerowanej.
Gdzie powinien wskazywać tag canonical na podstronach paginacji?
Na własny adres danej podstrony (canonical samoreferencyjny). Strona 3 wskazuje na stronę 3, a nie na stronę 1 ani na stronę „zobacz wszystkie”, chyba że ta wersja faktycznie istnieje i działa wydajnie.
Co zrobić z adresem pierwszej podstrony paginacji?
Pierwsza strona powinna być dostępna pod jednym adresem, np. /kategoria. Jeśli wersja ?page=1 lub /strona/1/ też działa i powiela treść, przekieruj ją 301 na adres główny. Linki wewnętrzne, w tym „do pierwszej strony”, kieruj na wersję czystą.
Czy Google nadal korzysta ze znaczników rel next i rel prev?
Nie. Google zrezygnował z używania ich jako sygnału indeksowania, o czym poinformował w marcu 2019 roku. Mogą pozostać w kodzie, bo inne wyszukiwarki, np. Bing, oraz niektóre narzędzia potrafią je odczytać, ale nie zastąpią zwykłych linków HTML między stronami serii.