
Wyszukiwanie semantyczne i semantic SEO
Semantyczne SEO - jak pozycjonować stronę w erze encji i sztucznej inteligencji?
Czy samo powtarzanie frazy w nagłówkach i treści wystarcza, żeby strona wygrywała w Google i była cytowana przez wyszukiwarki AI? Już nie. Semantyczne SEO (inaczej SEO semantyczne, a w języku angielskim semantic SEO) to podejście, w którym optymalizujesz treść, strukturę i metadane pod kątem zrozumienia tematu, kontekstu i intencji wyszukiwania (search intent), a nie dosłownego dopasowania leksykalnego pojedynczych słów kluczowych. Zamiast pytać, ile razy użyć frazy, pytasz, czy strona odpowiada na pytanie wyczerpująco i czy wyszukiwarka potrafi jednoznacznie rozpoznać, o czym piszesz. Punktem wyjścia jest semantyka, czyli nauka o znaczeniu słów i zdań: wyszukiwarka porównuje już nie same słowa, lecz ich znaczenia.
W praktyce sprowadza się to do trzech filarów. Pierwszy to entity SEO: identyfikacja kluczowych encji (osób, miejsc, produktów, koncepcji) i ich atrybutów w Twojej branży, czyli jednostek znaczeniowych, na których opiera się wyszukiwanie semantyczne (semantic search) i Graf Wiedzy Google. Drugi to topical authority budowane przez klastry tematyczne, czyli strony filarowe (pillar pages) i powiązane artykuły, które razem wyczerpują zagadnienie. Trzeci to dane strukturalne Schema.org (JSON-LD lub Microdata), dzięki którym roboty rozumieją relacje między bytami na stronie, a Ty zyskujesz szansę na rich snippets. W dalszej części artykułu dowiesz się, jak te elementy połączyć w jedną optymalizację semantyczną, czym różni się ona od tradycyjnego podejścia opartego na frazach i jak przekłada się na widoczność w wynikach wyszukiwania.
Co to jest semantyczne SEO (semantic SEO)?
Semantyczne SEO (semantic SEO) to optymalizacja treści, struktury i danych strukturalnych pod znaczenie, kontekst i intencję wyszukiwania, a nie pod pojedyncze frazy. W krótkiej definicji: wyszukiwarka ma osiągnąć zrozumienie, o jakich encjach i relacjach jest strona, a użytkownik ma dostać pełną odpowiedź na swoje pytanie. Semantyka, czyli znaczenie wyrażeń, jest punktem wyjścia, a słowa kluczowe pozostają jednym z jej elementów.
Czym różni się semantyczne SEO od tradycyjnego pozycjonowania?
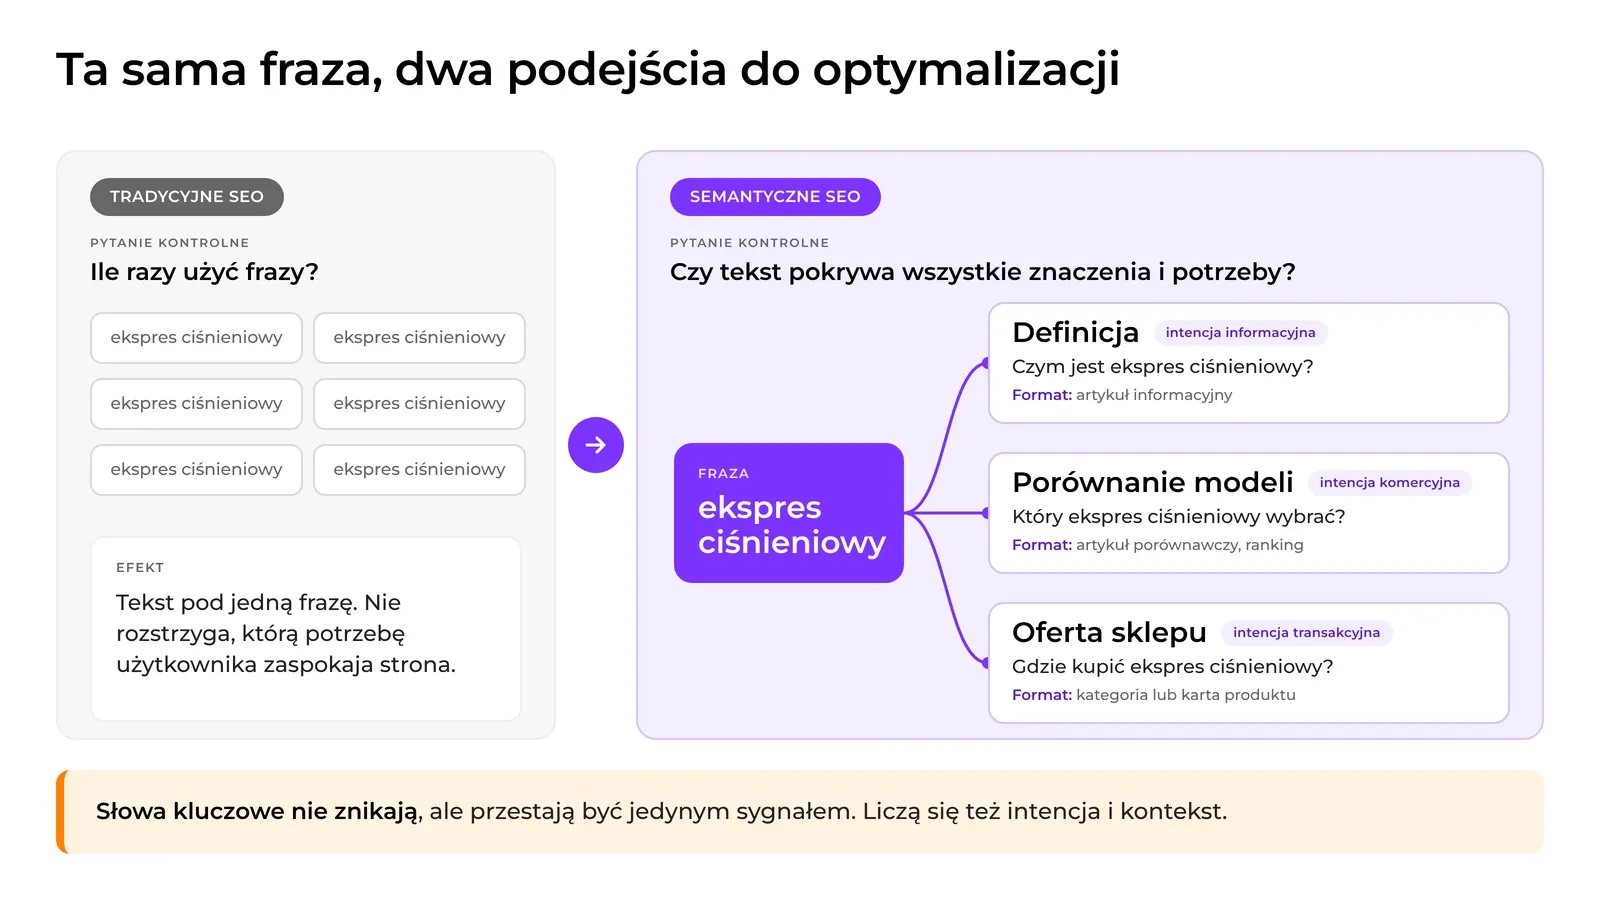
Semantyczne SEO rezygnuje ze sztywnego dopasowywania słów kluczowych na rzecz analizy intencji użytkownika, kontekstu i relacji między pojęciami w Knowledge Graph. Słowa kluczowe nie znikają, ale przestają być jedynym sygnałem.
Kluczowe znaczenie zrozumienia intencji użytkownika polega na tym, że ta sama fraza w różnych kontekstach oznacza różne potrzeby. Osoba, która wpisuje w internecie hasło „ekspres ciśnieniowy”, może szukać definicji, porównania modeli albo oferty sklepu. Optymalizacja pod jedną frazę nie rozstrzyga, którą z tych potrzeb zaspokaja strona, dlatego analiza zapytań użytkowników i ich intencji jest ważnym punktem wyjścia. Semantyka zmienia też pytanie kontrolne: zamiast liczyć powtórzenia frazy, sprawdzasz, czy tekst pokrywa wszystkie znaczenia i potrzeby związane z tematem.
Równowaga nasycenia fraz i profilaktyka spamu
Tradycyjne pozycjonowanie stron opierało się na dopasowaniu leksykalnym, czyli ścisłym dopasowaniu fraz (exact match) i keyword stuffingu. Przy podejściu semantycznym za orientacyjnie bezpieczne uznaje się keyword density (zagęszczenie fraz kluczowych) na poziomie 0,5-2%, co ogranicza ryzyko filtrów. Zamiast kolejnych powtórzeń lepiej dodać synonimy, powiązane pojęcia i hierarchię informacji, które pokazują pełny zakres tematu. Optymalizacja pod jedną frazę prowadzi do powtórzeń, a semantycznie powiązane wyrażenia pozwalają opisać temat szerzej i bardziej naturalnie. Ważne jest, aby zagęszczenie fraz traktować jako sygnał kontrolny, a nie cel.
Czym jest semantyka i jak odnosi się do SEO?
Semantyka to dział językoznawstwa, który bada znaczenie słów, wyrażeń i zdań, a semantyczne SEO przenosi tę perspektywę na optymalizację stron pod wyszukiwarki.
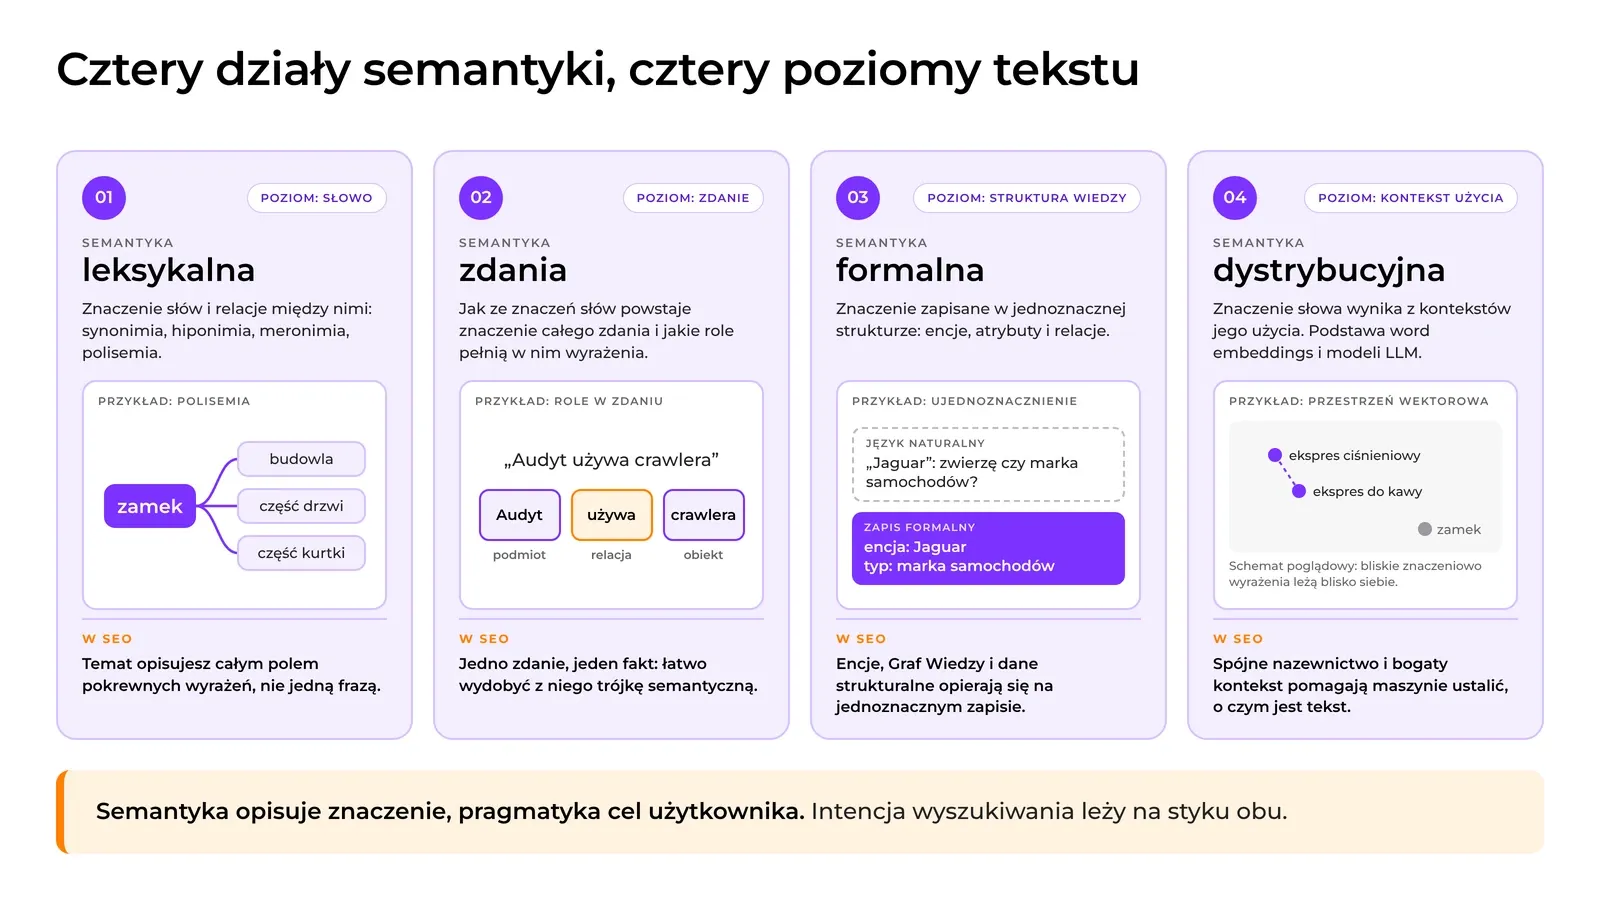
Czym dokładnie zajmuje się semantyka? Definicja jest krótka: semantyka zajmuje się znaczeniem wyrażeń językowych, czyli tym, co oznaczają słowa, frazy i całe zdania. Celem semantyki jest zrozumienie, jak znaczenie powstaje w języku naturalnym, czyli takim, jakim posługują się ludzie, a nie w sztucznym języku programowania. Innymi słowy, semantyka odpowiada na pytanie, co dane wyrażenie znaczy w danym kontekście, a nie tylko jak jest zapisane. Semantyka zajmuje się też relacjami między znaczeniami, na przykład tym, kiedy dwa różne słowa opisują to samo. W językoznawstwie wyróżnia się wiele działów semantyki, a dla semantycznego SEO największe znaczenie mają cztery: semantyka leksykalna, semantyka zdania, semantyka formalna i semantyka dystrybucyjna. Każda z nich odnosi się do innego poziomu tekstu: słowa, zdania, struktury wiedzy i kontekstu użycia.
Semantyka leksykalna: znaczenie słów i relacje między nimi
Semantyka leksykalna opisuje znaczenie słów oraz relacje, w jakie wchodzą one w języku. Do najważniejszych należą synonimia (różne słowa o zbliżonym znaczeniu), hiponimia i hiperonimia (relacja między pojęciem szczegółowym a ogólnym, np. „ekspres ciśnieniowy” i „ekspres do kawy”), meronimia (część i całość, np. „filtr” i „ekspres”) oraz polisemia, czyli wieloznaczność jednego słowa. To samo słowo w różnych kontekstach może mieć inne znaczenie: „zamek” oznacza budowlę, część drzwi albo część kurtki. Semantyka leksykalna pokazuje więc, że znaczenie słów zależy od otoczenia, w którym występują, a ich znaczenia trzeba rozstrzygać na podstawie kontekstu.
Podstawą zrozumienia relacji między słowami jest kontekst, a wiedza o nich pozwala lepiej zrozumieć, dlaczego wyszukiwarka łączy różne sformułowania w jedną intencję. Podobnie działa polska fleksja: jedno słowo ma w języku polskim wiele form, dlatego narzędzia do analizy tekstu sprowadzają je do formy podstawowej (lematyzacja). Dla SEO wynika z niej prosta zasada: temat opisuje się całym polem pokrewnych wyrażeń, a nie jedną frazą. Wyrażenia bliskoznaczne, nazwy ogólniejsze i bardziej szczegółowe oraz części składowe tworzą semantyczne słowa kluczowe, dzięki którym strona może pojawić się w wynikach wyszukiwania także na zapytania, których dosłownie nie zawiera.
Semantyka zdania: struktury i role semantyczne
Semantyka zdania opisuje, jak ze znaczeń pojedynczych słów powstaje znaczenie całego zdania. Struktury zdań przypisują wyrażeniom role: kto wykonuje czynność, na czym ona polega i czego dotyczy. Zdanie „Audyt używa crawlera” ma strukturę podmiot - relacja - obiekt, czyli taką, jaką mają trójki semantyczne (semantic triples) opisane niżej. Dlatego semantyka zdań ma znaczenie dla treści pisanych pod wyszukiwarki generatywne: ze zdania z jednym faktem łatwo wydobyć trójkę, a zdanie przeładowane wieloma wątkami trudniej zinterpretować. Zasada jest prosta: jedno zdanie, jeden fakt.
Semantyka formalna: znaczenie zapisane w strukturach wiedzy
Semantyka formalna opisuje znaczenie za pomocą narzędzi logiki, tak aby dało się je zapisać w jednoznacznej strukturze. Formalne podejście do znaczenia jest bliskie temu, co robią ontologie i bazy wiedzy: wyrażenia języka naturalnego zamieniają się w encje, atrybuty i relacje, czyli w trójki znane z modelu EAV. Zapis znaczenia w języku logiki eliminuje wieloznaczność języka naturalnego, a formalna definicja pojęcia wskazuje jego cechy i miejsce w hierarchii. Dzięki temu maszyna nie musi zgadywać, czy „Jaguar” oznacza zwierzę, czy markę samochodów. Warunkiem zrozumienia powiązań między encjami jest ich jednoznaczny zapis. Semantyka formalna jest więc teoretycznym zapleczem encji, Grafu Wiedzy i danych strukturalnych.
Semantyka dystrybucyjna: znaczenie wynika z kontekstu
Semantyka dystrybucyjna zakłada, że znaczenie słowa wynika z kontekstów jego użycia: słowa występujące w podobnym otoczeniu mają zbliżone znaczenie. Na tym założeniu opierają się word embeddings i modele językowe LLM, uczone na dużych zbiorach tekstów, także tych dostępnych w internecie. Są one częścią przetwarzania języka naturalnego (NLP). Wektorowa reprezentacja znaczenia pozwala porównywać sens zapytań i fragmentów treści, a nie tylko ich zapis, co pomaga w zrozumieniu znaczenia zapytania także wtedy, gdy użytkownik użył innych słów niż strona. W praktyce semantyka dystrybucyjna tłumaczy, dlaczego spójne nazewnictwo i bogaty kontekst wokół kluczowych pojęć pomagają maszynie ustalić, o czym jest tekst.
Semantyka a pragmatyka: intencja użytkownika
Semantyka opisuje znaczenie wyrażeń, a pragmatyka odnosi się do tego, co użytkownik chciał osiągnąć, używając ich w danej sytuacji. Intencja wyszukiwania leży na styku semantyki i pragmatyki: semantyka dostarcza narzędzi do opisu pojęć, ale sama nie rozstrzyga, którą potrzebę zaspokaja strona. Zrozumienie intencji wymaga więc obu perspektyw. Dlatego semantyczne SEO łączy analizę znaczeń z analizą intencji, a format treści dobiera do typu zapytań użytkowników: informacyjnych, nawigacyjnych, komercyjnych i transakcyjnych.
Semantyka kodu: czytniki ekranu i doświadczenie użytkownika
Semantyka dotyczy także kodu strony WWW. Znaczniki HTML5, takie jak header, nav, main czy article, opisują rolę elementów, dzięki czemu czytniki ekranu i roboty rozpoznają strukturę dokumentu. Poprawia to doświadczenie użytkownika korzystającego z technologii asystujących, ale nie zastępuje treści i nie gwarantuje lepszych pozycji w wynikach wyszukiwania. Czytelna struktura nagłówków H1-H3 pomaga też zwykłemu czytelnikowi szybciej znaleźć odpowiedź.
Od językoznawstwa do semantycznego SEO
Za początek semantycznego SEO uznaje się zwykle lata 2012-2013, czyli wdrożenie Knowledge Graph i algorytmu Hummingbird. W branży SEO to podejście nazywa się semantycznym SEO albo SEO semantycznym, a w języku angielskim semantic SEO. W języku polskim funkcjonują obie formy. W zakresie semantycznego SEO obie nazwy opisują to samo: projektowanie treści wokół encji, intencji i relacji zamiast listy fraz. Specjalista SEO, który stosuje to podejście, wychodzi od pytania, jakie znaczenia i jakie potrzeby kryją się za zapytaniami użytkowników, zapisanymi ich własnym językiem.
Ogólnie rzecz biorąc, dla osoby, która ma tworzyć treści, semantyka daje trzy praktyczne zasady:
- Opisuj temat wieloma wyrażeniami o pokrewnym znaczeniu, a nie jednym słowem.
- Zapisuj relacje między pojęciami w pełnych zdaniach i w czytelnej strukturze nagłówków.
- Rozstrzygaj wieloznaczność, dopisując kontekst do nazw własnych i terminów, które w innej branży mogą znaczyć coś innego.
Sprawdźmy potencjał Twojej strony
Podaj adres swojej strony i e-mail - odezwiemy się z konkretną analizą, bez zobowiązań.
Jak działają algorytmy Google i wyszukiwarki generatywne AI
Nowoczesne algorytmy NLP analizują semantyczny sens całych zapytań, a wyszukiwarki generatywne syntetyzują odpowiedzi z wielu źródeł. Semantyka zapytania, czyli znaczenie całego zdania, a nie pojedynczych słów, stała się dla nich punktem wyjścia.
Ewolucja algorytmów od porównywania znaków do przetwarzania języka naturalnego
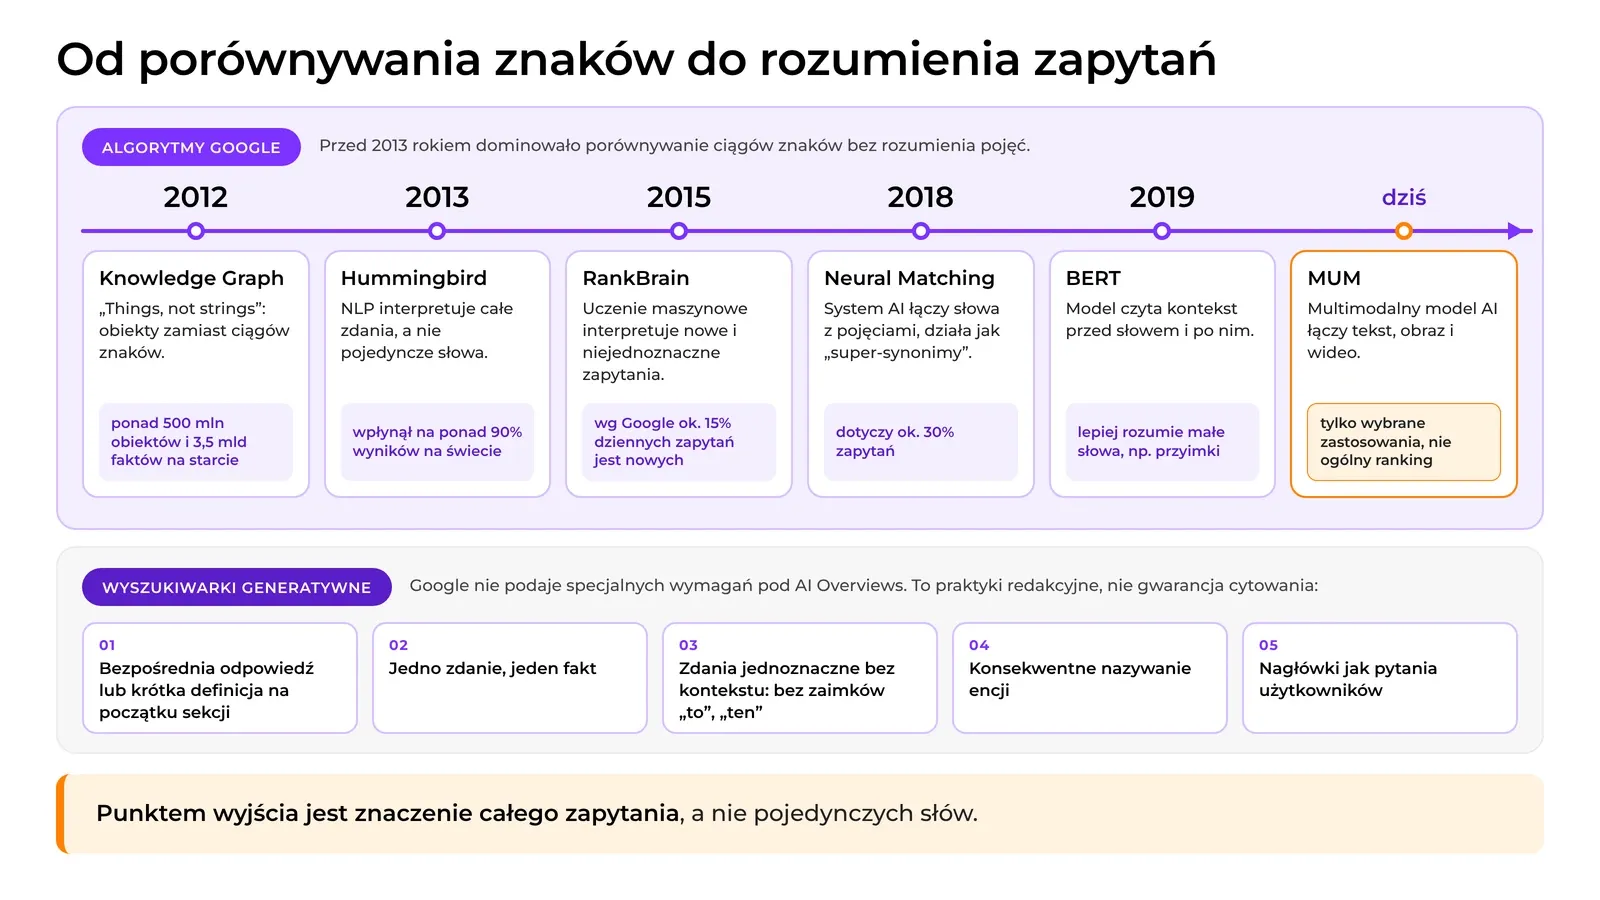
Przed 2013 rokiem dominowała wyszukiwarka leksykalna, która porównywała ciągi znaków bez rozumienia pojęć. Zmianę zapoczątkował w maju 2012 roku Google Knowledge Graph („things, not strings”), obejmujący na starcie ponad 500 mln obiektów i ponad 3,5 mld powiązanych faktów. Algorytm Hummingbird z 2013 roku wykorzystał NLP, czyli przetwarzanie języka naturalnego, do interpretacji całych zdań i według Google wpłynął na ponad 90% wyszukiwań na świecie.
| Przekonanie | Fakt |
|---|---|
| Schema.org gwarantuje rich results i wysoką pozycję | Dane strukturalne pomagają zrozumieć treść i mogą kwalifikować do rich results, ale nie gwarantują ich wyświetlenia |
| RankBrain jest sterowany przez Dwell Time i CTR | Przedstawiciele Google zdementowali bezpośredni wpływ tych metryk |
| MUM decyduje o całym rankingu | Według Google MUM nie służy do rankingowania wyników (stan na 2022 rok) |
| Semantyka wyklucza słowa kluczowe | Podejście semantyczne uzupełnia je o kontekst i relacje między pojęciami |
Rola BERT, MUM i RankBrain
RankBrain Google (2015) to system uczenia maszynowego, który pomaga interpretować nowe i niejednoznaczne zapytania; według Google około 15% codziennych zapytań nigdy wcześniej nie padło. Łączy różne sformułowania tej samej intencji w jedno pojęcie, dlatego strona może wyświetlać się na frazy, których dosłownie nie zawiera. Neural Matching (2018) to system AI, który łączy słowa z pojęciami i działa jak „super-synonimy“; według Google dotyczy około 30% zapytań. Dużą rolę odgrywa tu kontekst: BERT (2019) jest dwukierunkowym modelem transformatorowym analizującym pełny kontekst słów w języku naturalnym przed danym wyrazem i po nim, co pozwala lepiej zrozumieć znaczenie małych słów, takich jak przyimki, w zapytaniu. MUM to multimodalny model AI, który potrafi łączyć informacje z tekstu, obrazu i wideo, ale według Google (stan na 2022 rok) nie służy do rankingowania wyników wyszukiwania. Termin latent semantic indexing nie opisuje działania tych systemów. Dla osoby, która ma tworzyć treści, wniosek jest praktyczny: pisz naturalnym językiem i odpowiadaj na konkretny problem czytelnika.
Praktyki redakcyjne pod AI Overviews
W silnikach generatywnych (GEO, generative engine optimization), w tym w mechanizmach Google Search Generative Experience (SGE), nie ma osobnego znacznika ani listy wymagań. Google podaje, że do AI Overviews nie są potrzebne dodatkowe optymalizacje ani dane strukturalne Schema.org, a strona musi być zaindeksowana i kwalifikować się do wyświetlania z fragmentem w zwykłych wynikach. Poniższe praktyki redakcyjne nie są więc wymogami Google, ale ułatwiają wydzielenie z tekstu samodzielnych odpowiedzi: zacznij sekcję od bezpośredniej odpowiedzi lub krótkiej definicji pojęcia, a każde zdanie oprzyj na jednym fakcie. Semantyka każdego zdania powinna być jednoznaczna bez kontekstu: unikaj zaimków typu „to” czy „ten”, które odnoszą się do poprzedniego akapitu. Nazywaj encje konsekwentnie, a nagłówki formułuj jak pytania użytkowników, językiem, którym zadają je klienci. Żadna z tych praktyk nie gwarantuje cytowania.
Czym są encje i jak powiązać je w treści?
Encje to jednoznacznie zidentyfikowane obiekty i pojęcia w Grafie Wiedzy Google (osoby, miejsca, produkty, koncepcje). Optymalizuje się je, opisując ich atrybuty i logiczne powiązania w treści. W entity SEO ważniejsze od liczby powtórzeń frazy jest to, czy robot rozpozna, o który byt chodzi. W semantyce formalnej odpowiednikiem encji są obiekty, a atrybutom odpowiadają ich własności, dlatego semantyka formalna dostarcza teoretycznych podstaw dla modelu opisanego poniżej. Każda encja potrzebuje jednoznacznej definicji w treści, a semantycznie powiązane encje, takie jak produkt i marka, warto opisywać obok siebie.
Modelowanie bytów w standardzie encja-atrybut-wartość
Encje opisuje się w modelu EAV: encja (np. „sklep internetowy”), atrybut (np. „platforma”) i wartość (np. „WooCommerce”). Każdą trójkę da się zapisać jako jedno zdanie, czyli tzw. semantic triples. Jak powiązać encje w treści strony WWW:
- Wypisz kluczowe byty branży i ich atrybuty.
- Przypisz im semantyczne słowa kluczowe: synonimy, wyrazy bliskoznaczne i hasła spokrewnione (LSI).
- Rozstrzygnij niejednoznaczność (disambiguation), np. dopisując kontekst do nazwy.
- Umieść encje w adresie URL, Title, meta Description, nagłówkach H1-H3, atrybutach alt i akapitach.
Przykład hipotetyczny: dla pozycjonowania lokalnego encją jest „wizytówka firmy”, a atrybutem „kategoria działalności”; dla sklepów internetowych - „karta produktu” z atrybutem „wariant”.
Formalna taksonomia relacji semantycznych
Zbiór encji i relacji między nimi tworzy ontologię dziedziny, czyli uporządkowany opis tego, jakie byty istnieją w Twojej branży i jak się ze sobą wiążą. W językoznawstwie podobne zbiory pojęć i relacji opisuje semantyka leksykalna, a w informatyce ontologie. Relacje ontologiczne wyrażasz w treści konkretnymi czasownikami, a do powiązania encji stosuje się dziesięć ich typów:
| Relacja | Przykład (hipotetyczny) |
|---|---|
| uses | audyt używa crawlera |
| contains | klaster zawiera artykuły |
| produces | analiza produkuje raport |
| requires | schema wymaga poprawnej składni |
| measures | narzędzie mierzy widoczność |
| implements | strona wdraża dane strukturalne |
| contrasts | encja kontrastuje z frazą |
| feeds_into | audyt zasila plan treści |
| optimizes | redakcja optymalizuje nagłówki |
| complements | FAQ uzupełnia stronę filarową |
Narzędzia wspierające identyfikację encji
Google Natural Language API i IBM Watson NLU wykonują named entity recognition, czyli automatycznie wydobywają z tekstu encje, relacje logiczne i sentyment. Wynik porównaj z własną listą encji: brakujące byty to luki tematyczne. Wyszukiwarki AI dodatkowo zamieniają tekst w języku naturalnym na wektory (wektoryzacja tekstu), więc spójne nazewnictwo encji ułatwia przypisanie fragmentu do zapytania.
Jak budować autorytet tematyczny za pomocą klastrów treści?
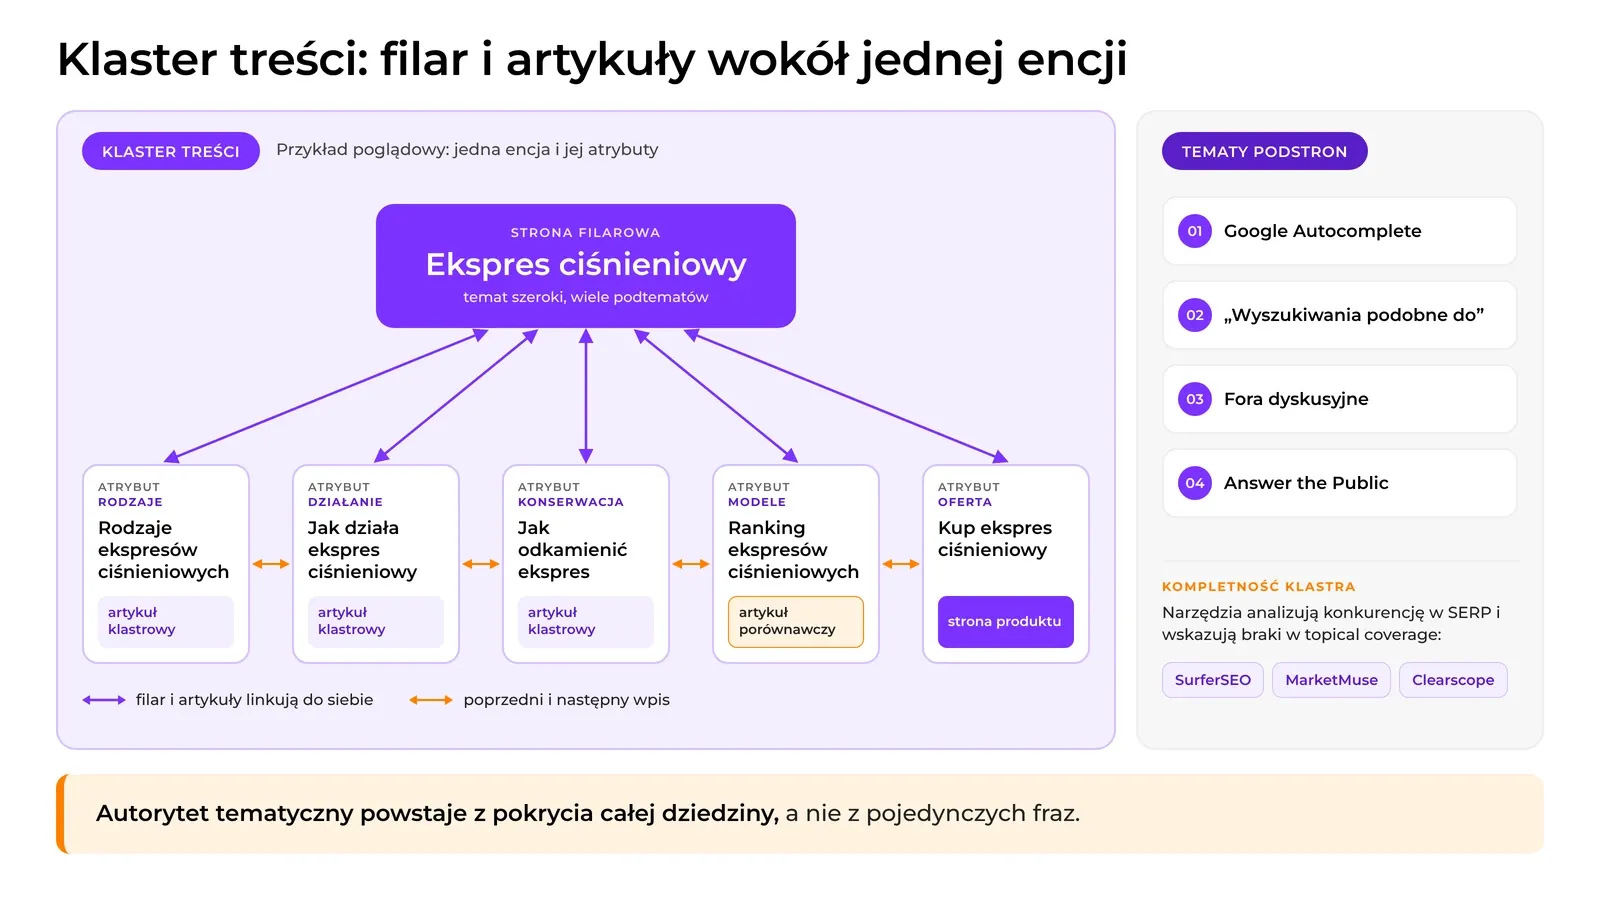
Topical authority powstaje wtedy, gdy strona filarowa i połączone z nią linkami wewnętrznymi artykuły klastrowe wyczerpują całą dziedzinę wiedzy, a nie pojedyncze frazy. Pokrycie dziedziny oznacza, że klaster opisuje wszystkie ważne encje, atrybuty i pytania użytkowników w danym obszarze. Semantyka całego klastra powinna być spójna: semantycznie powiązane artykuły rozwijają różne atrybuty tej samej encji.
Architektura strony filarowej i podstron klastrowych
Strona filarowa omawia temat szeroko i odsyła do podstron, a każdy artykuł klastrowy rozwija jedno zagadnienie i linkuje z powrotem do filaru. Taka struktura usprawnia indeksowanie przez roboty i buduje widoczność na zapytania long-tail. Linkuj nie tylko do filaru, ale i do sąsiednich wpisów: poprzedni artykuł i następny artykuł w ścieżce czytelnika tworzą logiczną sekwencję. Tematy podstron znajdziesz dzięki analizie zapytań użytkowników: w Google Autocomplete, w sekcji „Wyszukiwania podobne do”, na forach dyskusyjnych i w narzędziach typu Answer the Public, które pokazują realne pytania odbiorców. Grupowanie bliskich zapytań ułatwiają word embeddings, czyli wektorowa reprezentacja znaczenia słów. Kompletność sprawdzisz w SurferSEO, MarketMuse lub Clearscope, które analizują konkurencję w SERP, wskazują braki w topical coverage i podpowiadają semantyczne słowa kluczowe do uzupełnienia.
Format publikacji dla czterech intencji zapytań
Intencja wyszukiwania (search intent) bywa informacyjna, nawigacyjna, komercyjna lub transakcyjna. Około 45% zapytań w Google ma intencję lokalną i uruchamia Local Pack, więc w przypadku zapytań lokalnych część klastra warto oprzeć na stronach lokalnych, zgodnie z zasadami pozycjonowania lokalnego. Reguły decyzyjne:
| Sytuacja | Format |
|---|---|
| Szeroki temat, wiele podtematów | Strona filarowa |
| Wąskie pytanie informacyjne lub long-tail | Artykuł klastrowy z linkiem do filaru |
| Zapytanie komercyjne (porównanie, ranking) | Artykuł porównawczy powiązany z ofertą |
| Zapytanie transakcyjne lub lokalne | Strona usługi lub produktu |
| Treść ma kwalifikować się do rich results | Dodaj Schema.org zgodnie z dokumentacją danego typu |
Jak przygotować serwis pod wyszukiwarki AI we współpracy z agencją?
Strony internetowe dobrze przygotowane pod wyszukiwarki AI mają spójną treść, strukturę i dane strukturalne, które opisują te same encje i relacje.
Rola danych strukturalnych Schema.org oraz ich techniczne ograniczenia
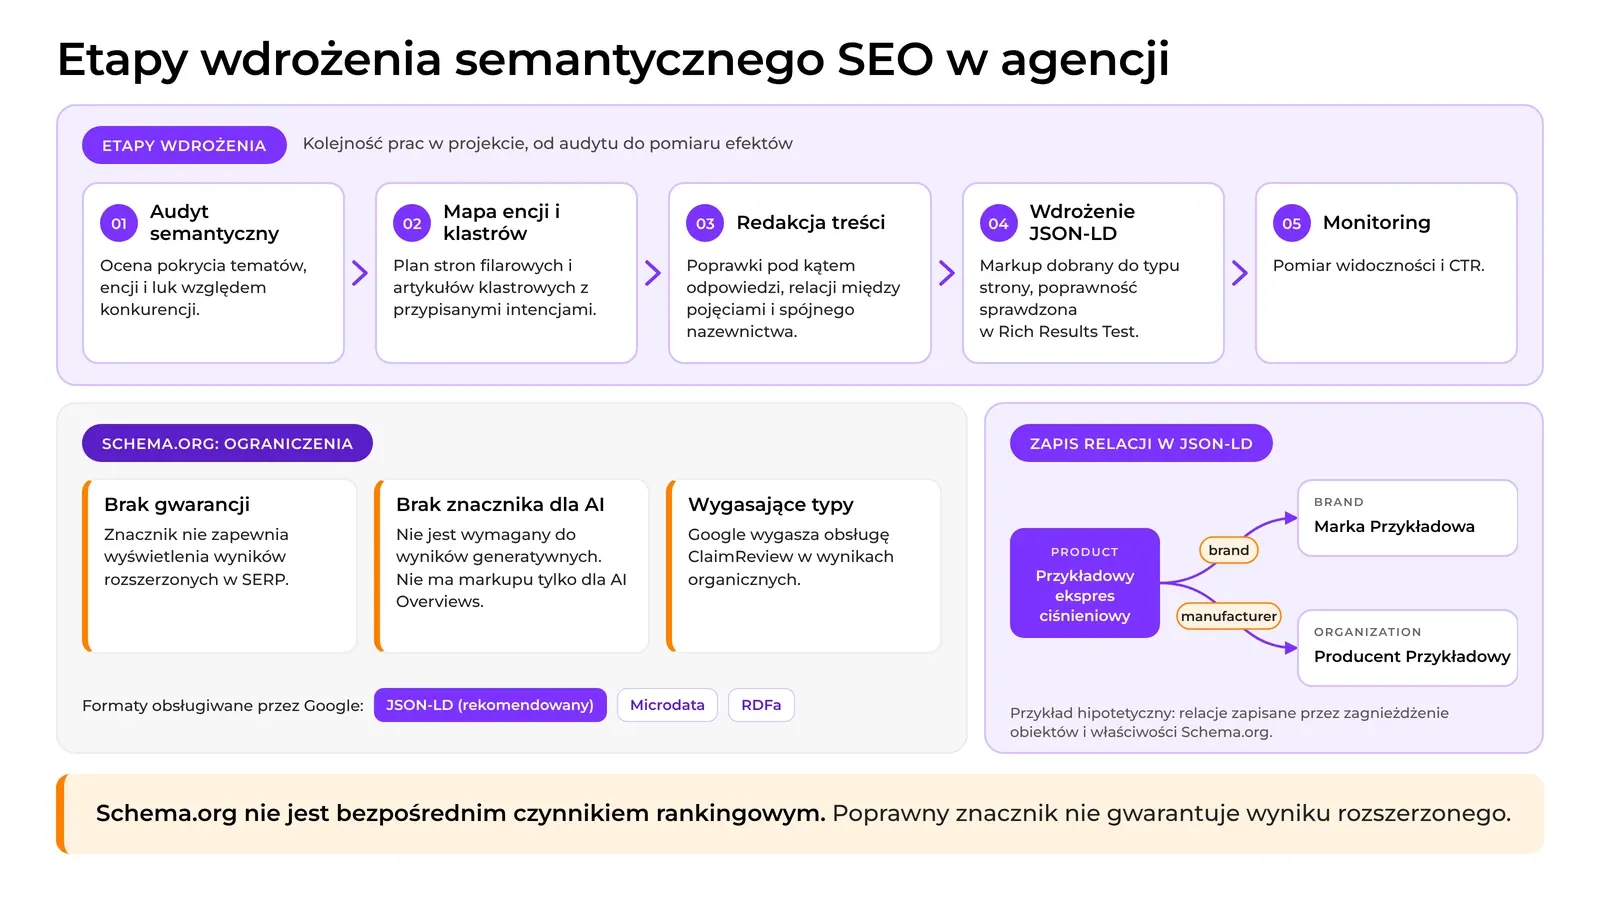
Dane strukturalne schema.org nie są bezpośrednim czynnikiem rankingowym Google. Umożliwiają ubieganie się o wyniki rozszerzone, co może podnieść CTR. Same nie podnoszą pozycji strony. Standard powstał w 2011 roku z inicjatywy Google, Bing i Yahoo!. Google obsługuje JSON-LD, Microdata i RDFa, ale oficjalnie rekomenduje JSON-LD, bo łatwiej go wdrożyć i utrzymać. Ograniczenia:
- Brak gwarancji. Implementacja nie zapewnia wyświetlenia wyników rozszerzonych w SERP.
- Brak znacznika dla AI. Dane strukturalne nie są wymagane do pojawienia się w wynikach generatywnych i nie istnieje markup przeznaczony wyłącznie dla AI Overviews.
- Wygasające typy. Google wygasza obsługę ClaimReview w wynikach organicznych.
Przykład hipotetyczny: w JSON-LD relacje między encjami (produkt, marka, producent) definiujesz przez zagnieżdżenie obiektów i właściwości Schema.org.
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "Przykładowy ekspres ciśnieniowy",
  "brand": {
    "@type": "Brand",
    "name": "Marka Przykładowa"
  },
    "manufacturer": {
    "@type": "Organization",
    "name": "Producent Przykładowy",
    "url": "https://example.com"
  },
  "offers": {
    "@type": "Offer",
    "price": "1999.00",
    "priceCurrency": "PLN"
  }
}
Właściwości brand i manufacturer zapisują powiązania między trzema encjami: produktem, marką i producentem. Robot nie musi ich wywnioskowywać z samego tekstu. Poprawność składni sprawdzisz w Rich Results Test, pamiętając, że poprawny znacznik nie gwarantuje wyniku rozszerzonego.
Etapy wdrożenia semantycznego SEO przez agencję
- Audyt semantyczny. Agencja ocenia pokrycie tematów, encje i luki względem konkurencji.
- Mapa encji i klastrów. Powstaje plan stron filarowych i artykułów klastrowych z przypisanymi intencjami.
- Redakcja treści. Teksty są poprawiane pod kątem odpowiedzi, relacji między pojęciami i spójnego nazewnictwa.
- Wdrożenie JSON-LD. Markup dobiera się do typu strony, a poprawność sprawdza w Rich Results Test.
- Monitoring. Mierzy się widoczność i CTR.
Jak ocenić kompetencje agencji semantycznej?
Znajomość etapów wdrożenia pozwala zadać agencji konkretne pytania, zanim podpiszesz umowę na pozycjonowanie stron. Kompetentna agencja semantyczna powinna odpowiedzieć twierdząco na większość z nich:
- Czy audyt obejmuje encje, intencje wyszukiwania i luki tematyczne względem konkurencji, a nie tylko listę fraz i liczbę linków?
- Czy przed napisaniem treści pokazuje mapę encji i klastrów z przypisanymi intencjami?
- Czy specjalista SEO prowadzący projekt potrafi wyjaśnić, jak powiąże encje w treści i w JSON-LD oraz dlaczego dane strukturalne nie są bezpośrednim czynnikiem rankingowym?
- Czy traktuje semantykę jako metodę pracy z encjami i intencjami, a nie jako modne hasło, i opisuje swój proces pracy nad semantic SEO krok po kroku?
- Czy pokazuje zrozumienie potrzeb klienta, czyli łączy intencje zapytań z celami biznesowymi?
- Czy unika obietnic gwarantowanej pozycji, rich results lub cytowania w AI Overviews? Żadna z tych rzeczy nie jest gwarantowana.
- Czy korzysta z narzędzi analizy semantycznej, takich jak SurferSEO, MarketMuse, Clearscope czy Google Natural Language API, i interpretuje ich wyniki, zamiast ślepo realizować wskazania narzędzia?
- Czy raportuje widoczność, CTR i konwersje, a nie wyłącznie pozycje na wybrane frazy?
- Czy pisze naturalnym językiem, a nie sztucznie nasyca tekst frazami exact match?
Opłacalność inwestycji w treści semantyczne
Dla decydenta, który inwestuje w widoczność w internecie, liczy się nie liczba opublikowanych artykułów, lecz to, czy treści przybliżają klientów do zakupu. Semantyczne SEO odpowiada na to na kilku poziomach:
- Pozycje. Autorytet tematyczny daje wyższe i stabilniejsze pozycje w rankingu organicznym niż optymalizacja pod wąską grupę fraz.
- Zasięg. Klastry treści budują widoczność na szeroki wachlarz zapytań z długiego ogona, a jedna struktura obsługuje pytania z większej liczby wariantów tematu.
- Zachowanie użytkowników. Kompletne i przejrzyste odpowiedzi mogą wydłużać średni czas na stronie i obniżać współczynnik odrzuceń, choć nie jest to efekt gwarantowany ani bezpośredni.
- Wizerunek. Pozycja eksperta branżowego ułatwia sprzedaż droższych usług i produktów. Wskaźniki DA i DR to zewnętrzne metryki narzędzi SEO, a nie oficjalne czynniki rankingowe Google, a semantyczne SEO nie gwarantuje ich wzrostu.
- Konwersja. Ruch dopasowany do intencji komercyjnej i transakcyjnej częściej kończy się zapytaniem lub zakupem.
W praktyce wygląda to różnie zależnie od modelu biznesowego (poniższe przykłady są ogólne, nie pochodzą z konkretnych wdrożeń). W B2B, gdzie decyzja zapada długo, treści informacyjne i porównawcze towarzyszą klientowi na kolejnych etapach wyboru dostawcy. W e-commerce, czyli przy pozycjonowaniu sklepów internetowych, kluczowe są karty produktów i kategorie z jednoznacznie opisanymi atrybutami. W segmencie premium treści ekspertowe budują wiarygodność, od której zależy gotowość do zapłaty wyższej ceny. Niezależnie od modelu strony internetowe powinny odpowiadać na pytania na każdym etapie decyzji.
Rentowność oceniaj, zestawiając koszt budowy klastra z wartością ruchu o intencji komercyjnej i transakcyjnej, a skuteczność mierz konwersjami, nie samymi pozycjami.
Najczęściej zadawane pytania
Czym jest semantyka w SEO i czym różni się od semantyki w językoznawstwie?
W językoznawstwie semantyka bada znaczenie słów, wyrażeń i zdań. W SEO, czyli w semantic SEO, ta sama semantyka służy do opisu tematu przez encje, relacje i intencje, więc odnosi się do tego, jak wyszukiwarka rozumie treść. Semantyka w SEO nie jest osobną dyscypliną, lecz zastosowaniem tych pojęć do optymalizacji, a jej definicje słownikowe pozostają punktem odniesienia.
Czy semantyczne SEO zastępuje słowa kluczowe?
Nie. Słowa kluczowe pozostają punktem wyjścia do analizy potrzeb użytkowników, lecz są organizowane w klastry tematyczne i mapowane na intencje oraz konkretne encje. Semantyczne słowa kluczowe, czyli synonimy i hasła pokrewne, uzupełniają frazę główną, a nie ją zastępują.
Czym różni się wyszukiwanie semantyczne od tradycyjnego?
Tradycyjne wyszukiwanie opiera się na ścisłej zgodności fraz z zapytaniem, a w skrajnych przypadkach na ich nadmiernym powtarzaniu (keyword stuffing). Wyszukiwanie semantyczne analizuje znaczenie zapytania, powiązania między pojęciami, hierarchię informacji i jego wieloaspektową intencję. Dzięki temu strona może się wyświetlać także na zapytania, których dosłownie nie zawiera.
Czy dane strukturalne Schema.org są bezpośrednim czynnikiem rankingowym?
Nie. Schema.org nie podnosi pozycji strony samą obecnością znaczników. Pomaga robotom interpretować encje i powiązania między nimi oraz zwiększa szansę na rich snippets, a ta może przełożyć się na wyższy CTR. Wyświetlenie wyników rozszerzonych nie jest jednak gwarantowane.
Jak Google identyfikuje encje na stronie internetowej?
Google traktuje encje (osoby, miejsca, produkty, koncepcje) jako podstawowe jednostki znaczeniowe i wpisuje je do Grafu Wiedzy. Rozpoznaje je na podstawie kontekstu w treści, konsekwentnego nazewnictwa i powiązań między pojęciami. Dane strukturalne mogą to ułatwić, ale nie są jedynym źródłem informacji.
Czy topical authority ma znaczenie w dobie AI Search?
Topical authority nie jest wymogiem ani gwarancją cytowania w wyszukiwarkach generatywnych. Google podaje, że do pojawienia się w AI Overviews nie są potrzebne dodatkowe optymalizacje, a obowiązują te same podstawy co w zwykłym wyszukiwaniu, w tym treści tworzone z myślą o ludziach i linki wewnętrzne ułatwiające odnalezienie treści. Rozbudowany klaster treści wokół strony filarowej nadal ma sens, bo realizuje te podstawy: obejmuje wiele pytań użytkowników i łączy powiązane artykuły linkami wewnętrznymi.